前言:
最近有想吧yolov8-pose部署到旭日派x3上,但速度并不如人意,跑300多ms,还不如吃了我算了,通过一些优化后现在一次推理速度约为100ms上下(推理层30ms+,后处理层60ms+),经过推理层和后处理层运行在不同线程,现在速度大概一轮推理是在50ms,如果用c++写应该可以更快
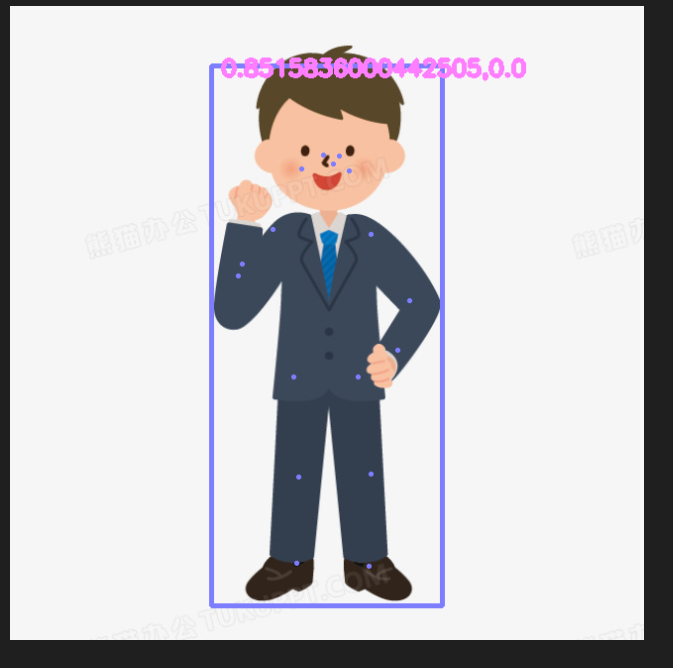
识别效果图
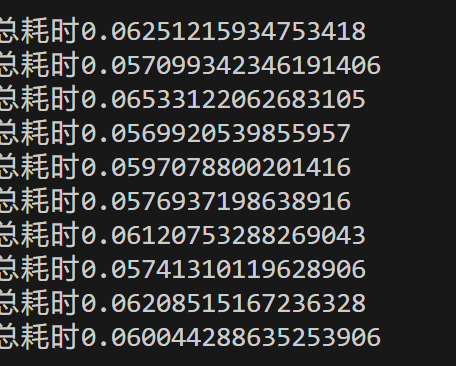
整体识别+绘图耗时(同时执行)
异步识别耗时:
模型上的调整:
1:激活函数替换
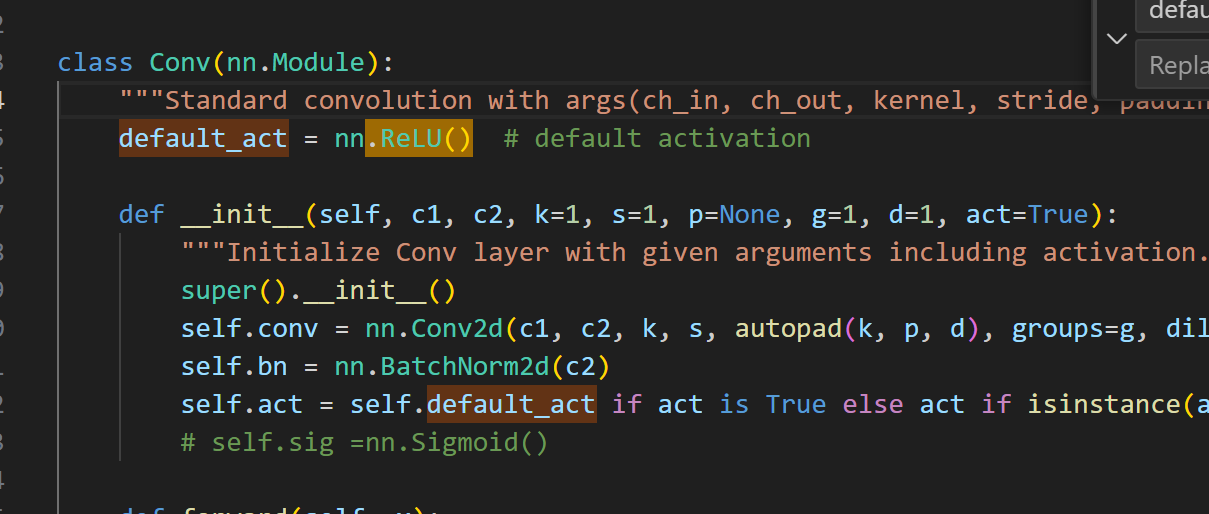
首先,我们需要吧原模型的silu激活函数都替换为relu函数,旭日派对silu函数的支持感觉存在bug,替换前cpu占用奇高,替换后速度进入正常,替换方法:进入conv.py,替换conv的default_act为 nn.Relu()即可(我是直接吧这个页面里所有的激活函数都换成relu了,但如果只是本次使用,只换这里就可以了)
2:卷积层替换为ghost conv,这个调整只是为了优化模型速度,由于v8 自带ghostconv ,我们调整一下yaml文件就可以了,我的yaml如图
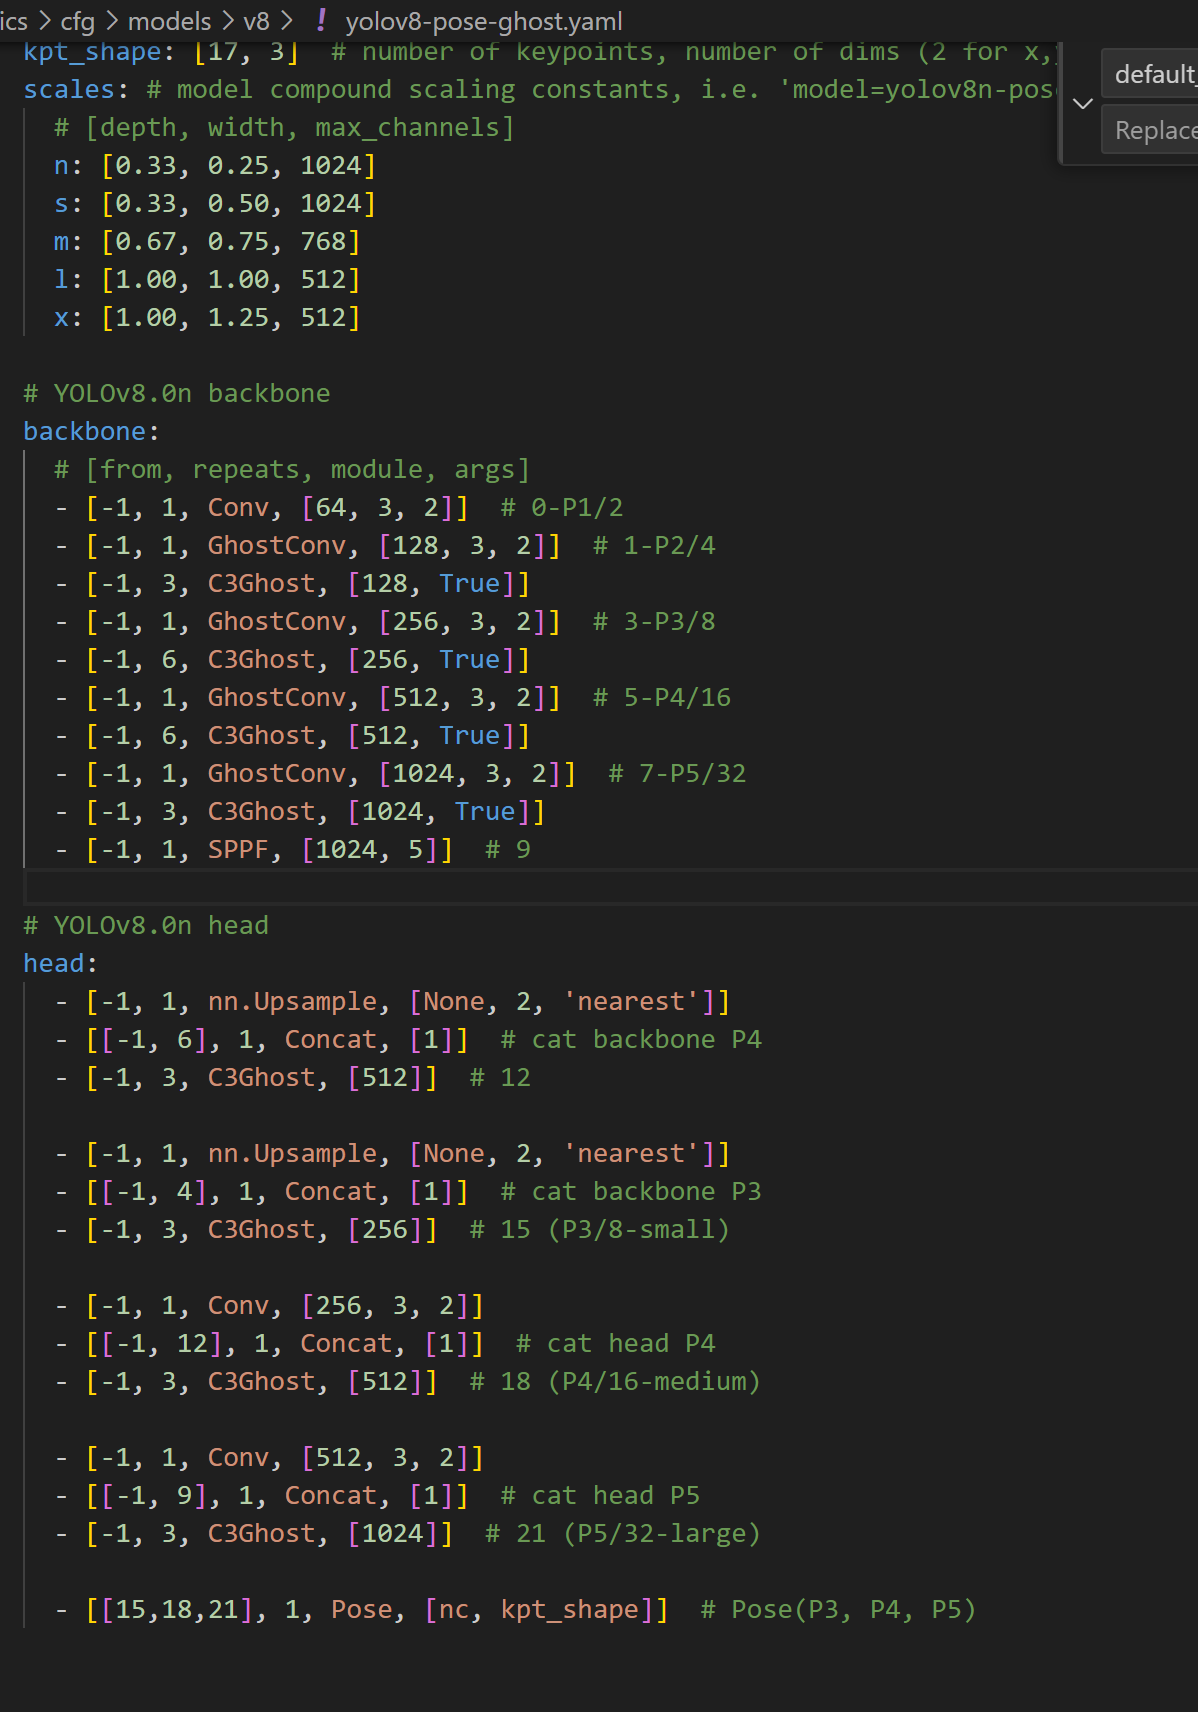
代码:
# Ultralytics YOLO ?, AGPL-3.0 license
# YOLOv8-pose keypoints/pose estimation model. For Usage examples see https://docs.ultralytics.com/tasks/pose

# Parameters
nc: 1 # number of classes
kpt_shape: [17, 3]  # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)
scales: # model compound scaling constants, i.e. 'model=yolov8n-pose.yaml' will call yolov8-pose.yaml with scale 'n'
 # [depth, width, max_channels]
 n: [0.33, 0.25, 1024]
 s: [0.33, 0.50, 1024]
 m: [0.67, 0.75, 768]
 l: [1.00, 1.00, 512]
 x: [1.00, 1.25, 512]

# YOLOv8.0n backbone
backbone:
 # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]]  # 0-P1/2
  - [-1, 1, GhostConv, [128, 3, 2]]  # 1-P2/4
  - [-1, 3, C3Ghost, [128, True]]
  - [-1, 1, GhostConv, [256, 3, 2]]  # 3-P3/8
  - [-1, 6, C3Ghost, [256, True]]
  - [-1, 1, GhostConv, [512, 3, 2]]  # 5-P4/16
  - [-1, 6, C3Ghost, [512, True]]
  - [-1, 1, GhostConv, [1024, 3, 2]]  # 7-P5/32
  - [-1, 3, C3Ghost, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]]  # 9

# YOLOv8.0n head
head:
  - [-1, 1, nn.Upsample, [None, 2, 'nearest']]
  - [[-1, 6], 1, Concat, [1]]  # cat backbone P4
  - [-1, 3, C3Ghost, [512]]  # 12

  - [-1, 1, nn.Upsample, [None, 2, 'nearest']]
  - [[-1, 4], 1, Concat, [1]]  # cat backbone P3
  - [-1, 3, C3Ghost, [256]]  # 15 (P3/8-small)

  - [-1, 1, Conv, [256, 3, 2]]
  - [[-1, 12], 1, Concat, [1]]  # cat head P4
  - [-1, 3, C3Ghost, [512]]  # 18 (P4/16-medium)

  - [-1, 1, Conv, [512, 3, 2]]
  - [[-1, 9], 1, Concat, [1]]  # cat head P5
  - [-1, 3, C3Ghost, [1024]]  # 21 (P5/32-large)

  - [[15,18,21], 1, Pose, [nc, kpt_shape]]  # Pose(P3, P4, P5)
完成后,我们就可以训练了,建议第一次是先用小数据集训练1~2个epoch,确认速度
训练完成后,进行bin文件导出,由于v8的最终层里有几个reshape,和bpu不支持的concat以及减法,所以拉出来到后处理层去写,我们需要打开nn.module.head.py文件,做出下面的调整
detect的forward添加如下代码
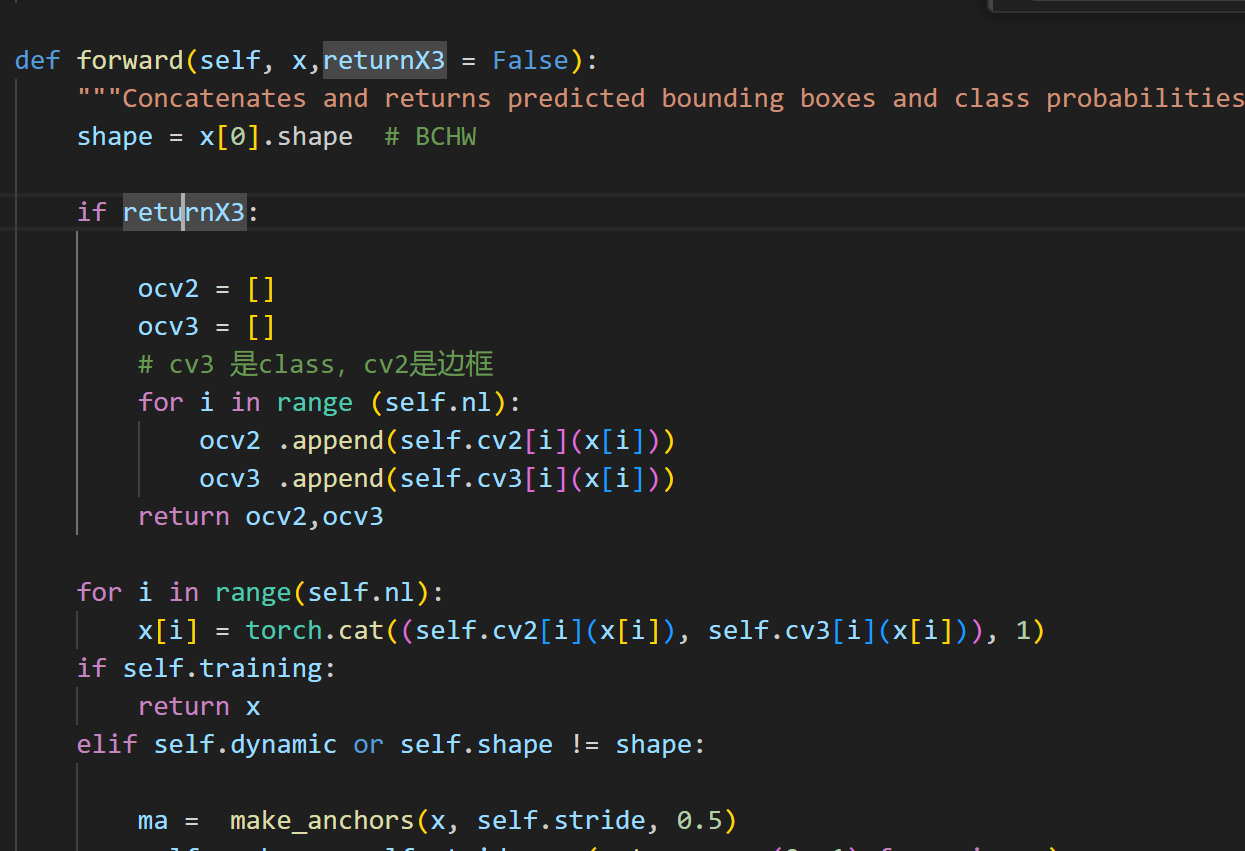
 def forward(self, x,returnX3 = False):
 """Concatenates and returns predicted bounding boxes and class probabilities."""
 shape = x[0].shape  # BCHW

 if returnX3:

 ocv2 = []
 ocv3 = []
 # cv3 是class,cv2是边框
 for i in range (self.nl):
 ocv2 .append(self.cv2[i](x[i]))
 ocv3 .append(self.cv3[i](x[i]))
 return ocv2,ocv3
然后,在下面的pose中添加如下代码,即可导出onnx
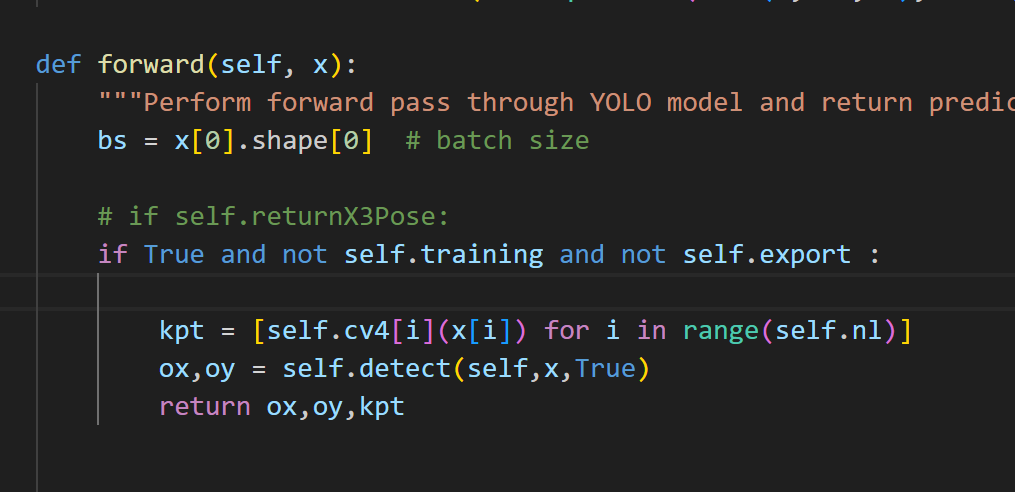
 # if self.returnX3Pose:
 if True and not self.training and not self.export :

 kpt = [self.cv4[i](x[i]) for i in range(self.nl)]
 ox,oy = self.detect(self,x,True)
 return ox,oy,kpt
注意,这里有个if true,是因为我还没想到更好的从外面带进来状态时想的办法,只有导出onnx/导出其他模型时才为true,否则为false,不然训练时测试时后面会报错,这里的修改不会影响先前训练出的结果
然后,导出onnx模型,再用官方工具检查一下,如果所有节点均为bpu节点,那么就可以拿去使用,否则需要检查是否有那步有遗漏
得到bin模型后,替换我上传的附件,就可以看到效果了,目前的话,dfl层我说实话还是不太理解,为什么要对输出的结果进行reshape,concat我也不太理解,也就先不误人子弟了,只先提供一个可以运行的环境抛砖引玉