基于Cython与C++多线程加速RDK板端YOLOv5后处理
首先附上项目Github链接Horizon_yolov5_tools,路过的兄弟姐妹们赏个Star叭~-
引言
之前有做一套基于RDK X3的yolov5工具库,还申请下来了软件著作权,不过存在一些问题,工具库的主要内容是YOLOv5快速后处理函数,该函数固定将输出的boxes分为21个子boxes(16+4+1)再开启21个线程进行阈值遍历搜索,然后再进行boxes解码和nms(非极大值抑制)等后续计算处理,而RDK X5的CPU核心数增加到了8个,最佳运算线程数必然发生变化,并且之前也打算进一步更新这个软件,让线程数成为一个可指定的参数,借此机会,再把旧版快速后处理函数内存管理不当的问题解决。
一、YOLOv5后处理流程
先来看看YOLOv5的模型结构吧。-
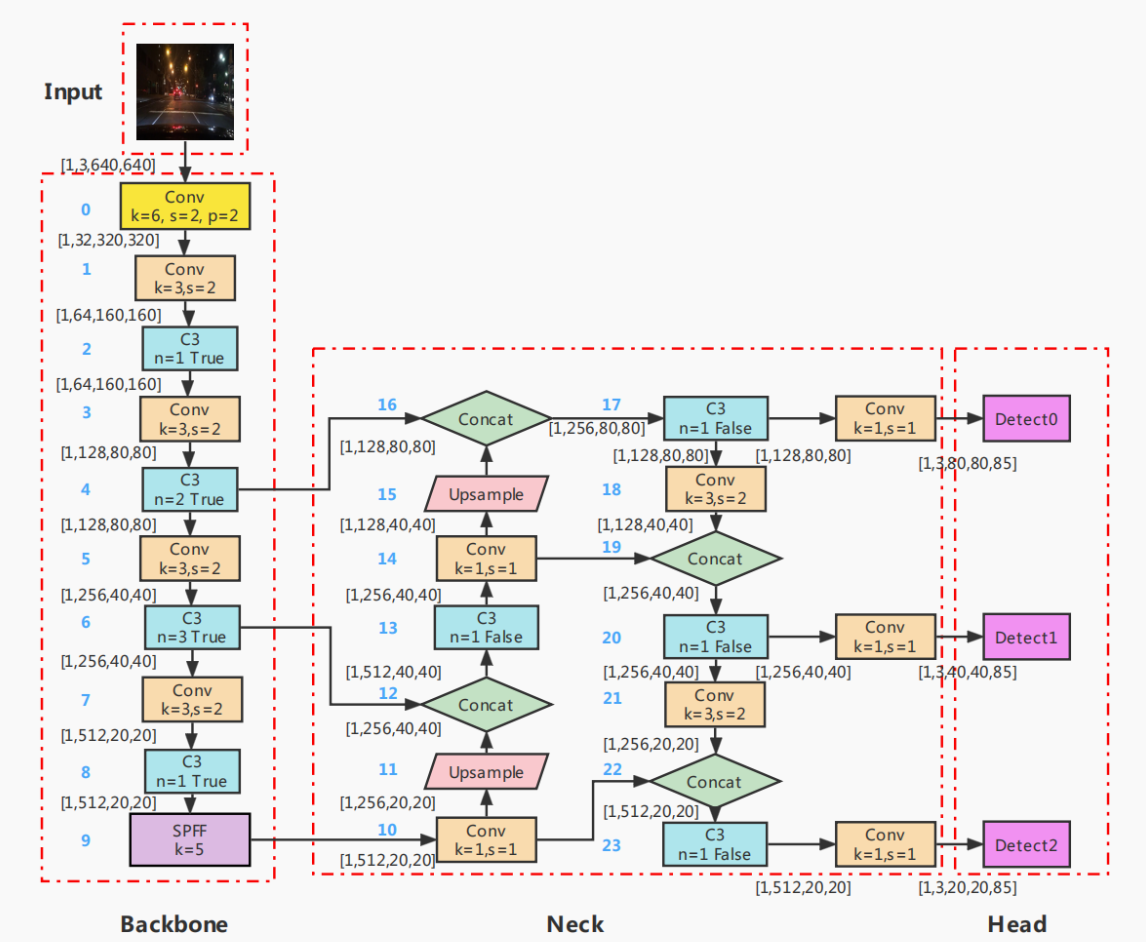
在输出层的部分,也就是最后3个
Conv(卷积层)之后的部分,图中没有表示的是:
- 最后这3个
Conv分别将3个输出张量卷积到255通道,255来自先验框数量 x (类别数+5),在官方模型中先验框数量为3,类别数为80。 - 卷积过后产生的尺寸分别为
1x255x80x80、1x255x40x40和1x255x20x20的张量,经过reshape变为3个1x3x85xhxw的张量后transpose成1x3xhxwx85的张量。 - 将3个
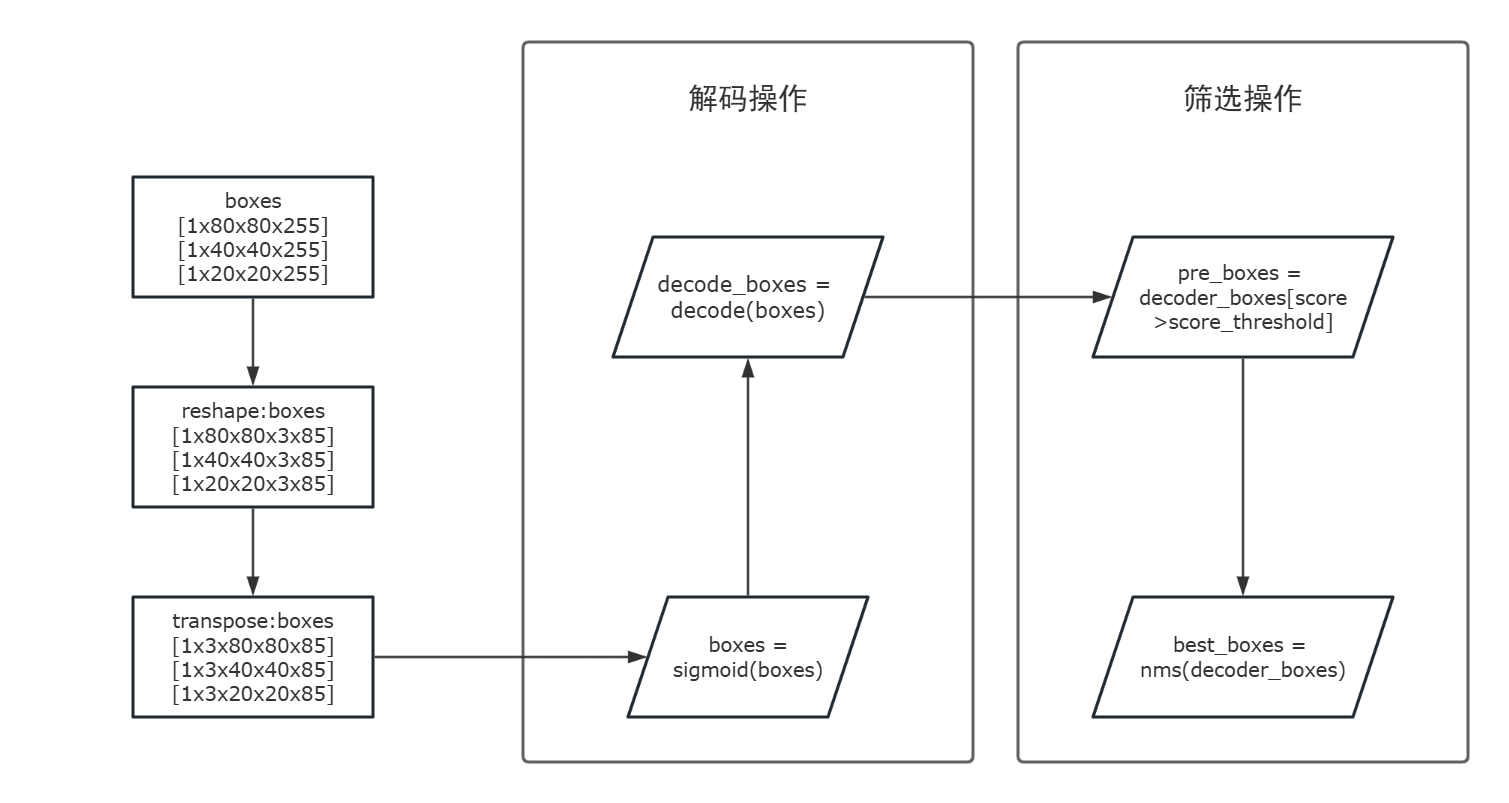
1x3xhxwx85的boxes张量解码,得到的还是形状尺寸完全相同的3个boxes,但此时每个预测格子中的目标信息都已经被解码转换到了我们可以直接理解的目标信息,,于是将3个boxes合并,并将第2至第4维统合,得到的输出张量尺寸为1x(h/8*w/8 + h/16*w/16 + h/32*w/32)x(classes_num+5),在官方的640尺寸80类模型中,这个尺寸为1x25200x85。也就是有25200个可能的目标框,而第三维这边长度为85的数据排布方式为[中心x坐标,中心y坐标,目标框宽度w,目标框宽度h,框置信度,cls0置信度,cls1置信度,...,cls80置信度]。
1.1.官方版本YOLOv5后处理步骤
得到这个1x25200x85的张量后,可以将第三维每个长度为85的序列视为一个box,也就是一共有25200个box,将每个box的框置信度与最大类别置信度相乘可以得到得分,与得分阈值进行对比筛选,可以过滤掉大部分的box,相应的过滤后的box只针对一个类别,因此box的数据排布变为[中心x坐标,中心y坐标,目标框宽度w,目标框宽度h,类别id,置信度得分]或[xmin,ymin,xmax,ymax,id,score](取决于算法)。-
经过过滤留下的这些box再经过nms(非极大值抑制)筛选,可以得到最终的预测框,nms的步骤如下:
- 在
boxes中寻找拥有最大得分的best_box与其对应的class_id。 - 在
boxes中删除这个box,将这个box添加到best_boxes中。 - 遍历
boxes中剩余的box,如果box的class_id与best_box相同,计算它们之间的IOU(交并比),如果IOU超过了nms阈值,则删除这个box。-
重复1-3,直到boxes被清空。-
最后得到的best_boxes就是输出的数据,他是一个二维数组,形状为[n,6]:
n表示预测得到的框数量- 数字6是每个
box的属性数据,包含一个图形框的4个属性和类别id与置信度得分。
1.2.RDK系列板卡YOLOv5后处理步骤
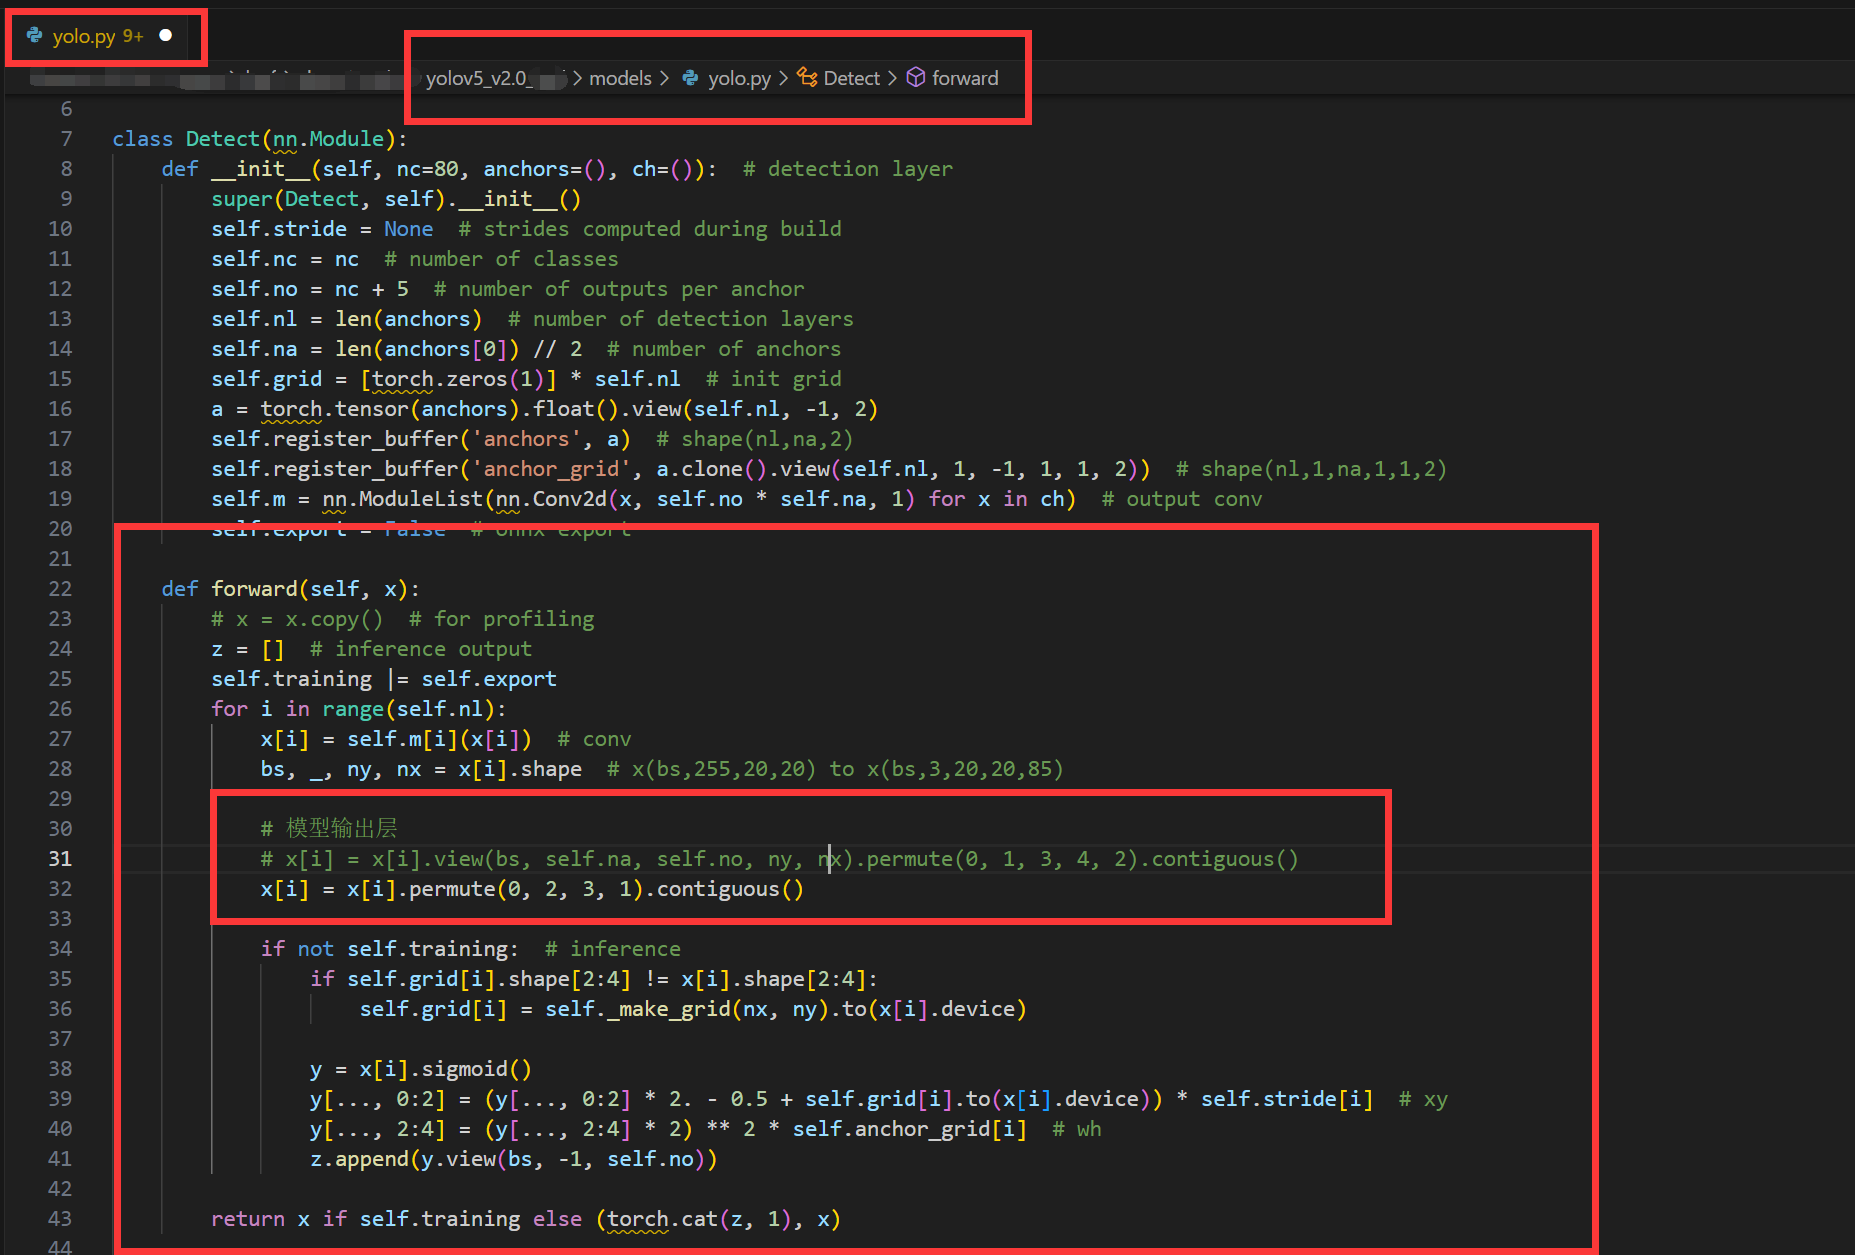
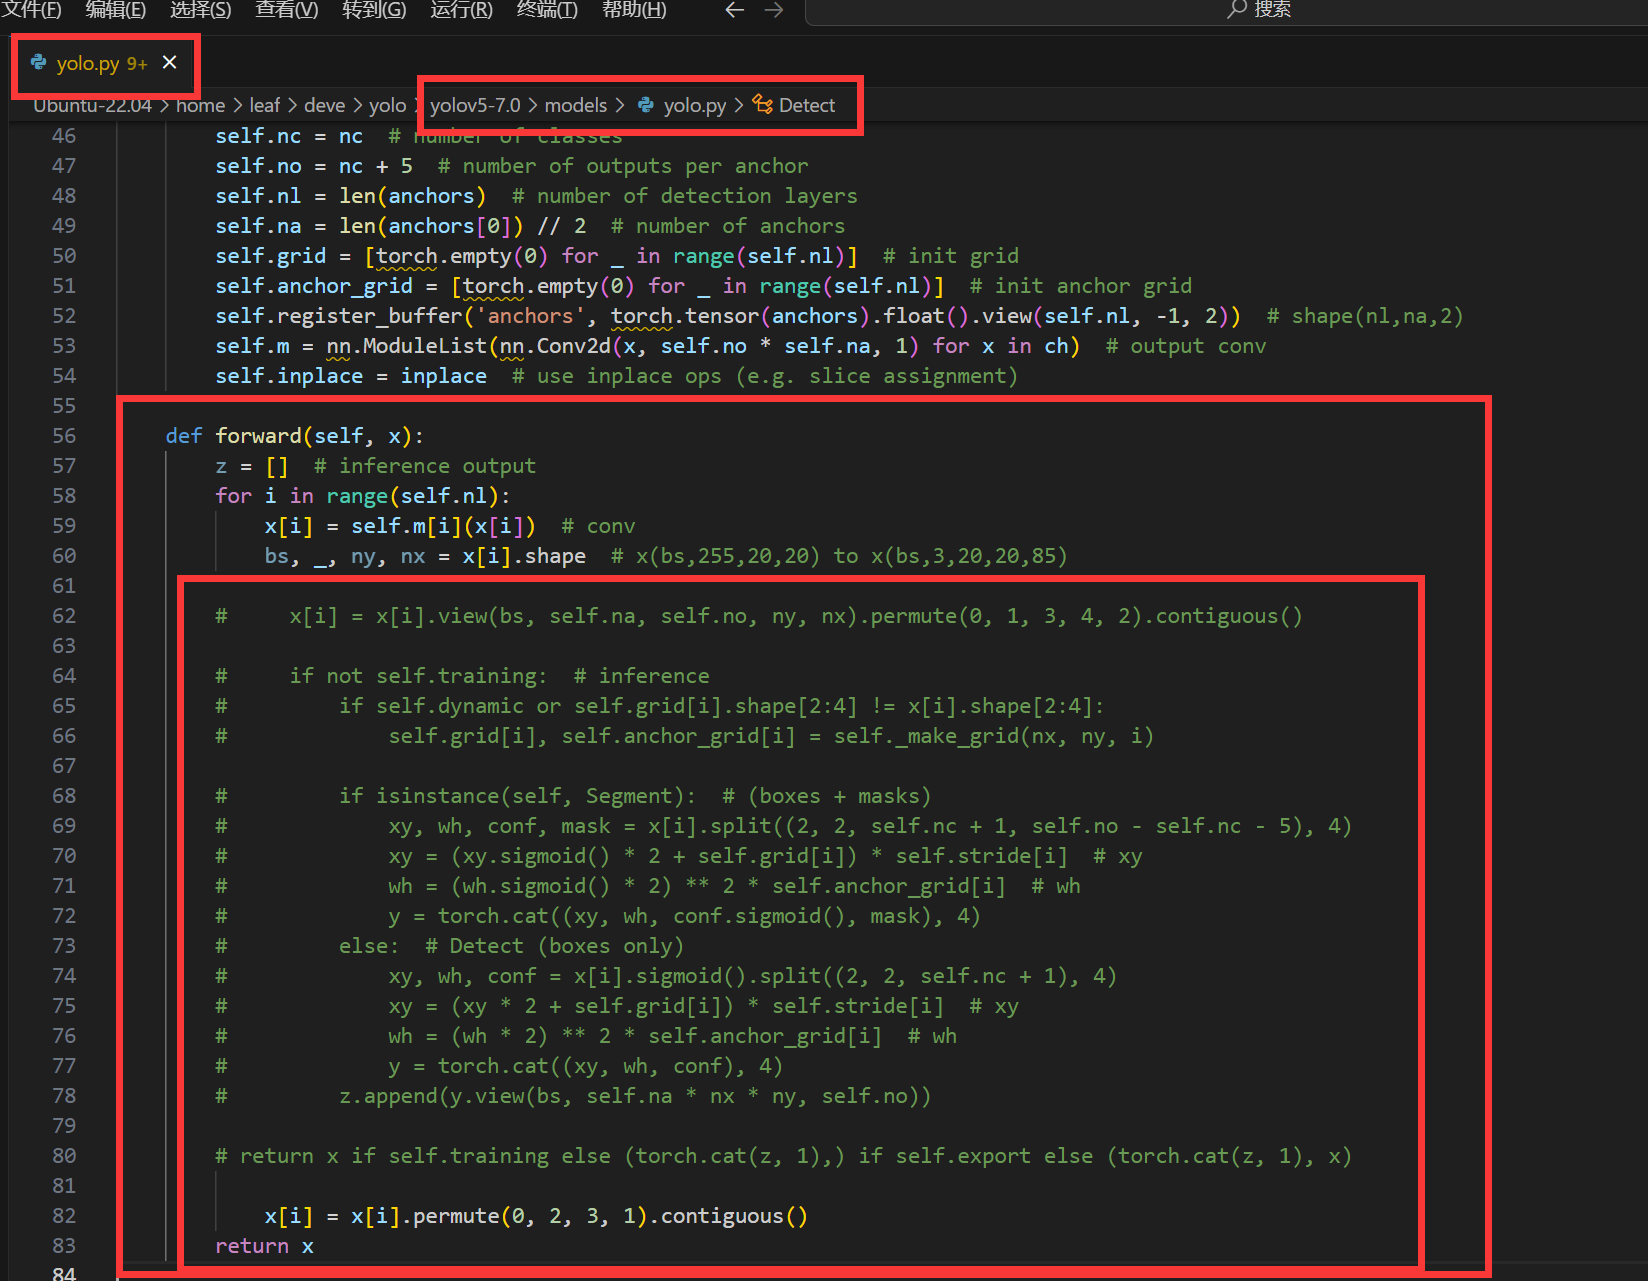
由于RDK板卡的BPU不支持加速5维计算,因此在YOLOv5输出检测头处,将3个1x255xhxw的张量reshape变为3个1x3x85xhxw的张量的操作以及后续所有5维操作都无法使用BPU加速,所以需要修改模型结构,将这些计算移动到CPU上进行。-
这部分修改不设计可训练参数,因此不需要重新训练模型,在导出模型时剔除不需要的层结构即可,常规的修改方式是将3个1x255xhxw的张量transpose成3个1xhxwx255的张量后直接输出,至于为什么还要经transpose再输出,我觉得是便于数据索引,因为只有张量的最后一维的内存是连续的。-
YOLOv5不同版本的代码不同,在较早版本中(如2.0),修改方法如下图:-
在较新版本中(如6.0,7.0)中,修改方法如下图:-
-
-
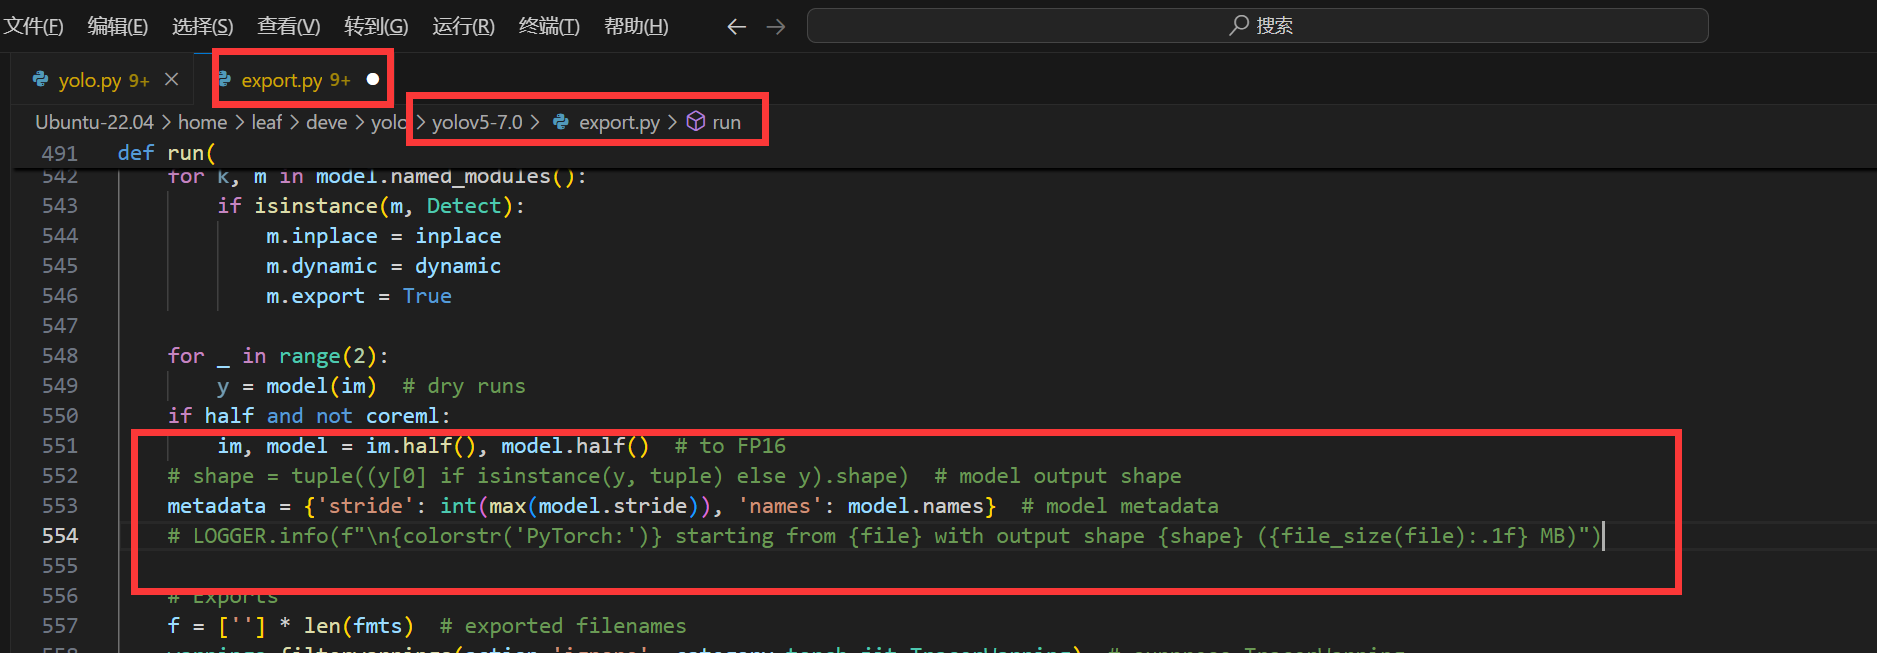
修改过后可以使用
YOLOv5框架自带的export.py导出onnx10/11模型,正常训练时要改回去。
二、其他后处理算法的缺点
2.1.RDK旧版Python后处理算法Demo
旧版基于Python的后处理运算性能十分一般,虽然是使用Numpy进行处理,但是有很多冗余计算,用以板卡上自带的”沙滩风筝图“为例,在RDK X3上的平均后处理速度为300ms左右。
2.2.RDK新版Python后处理算法Demo
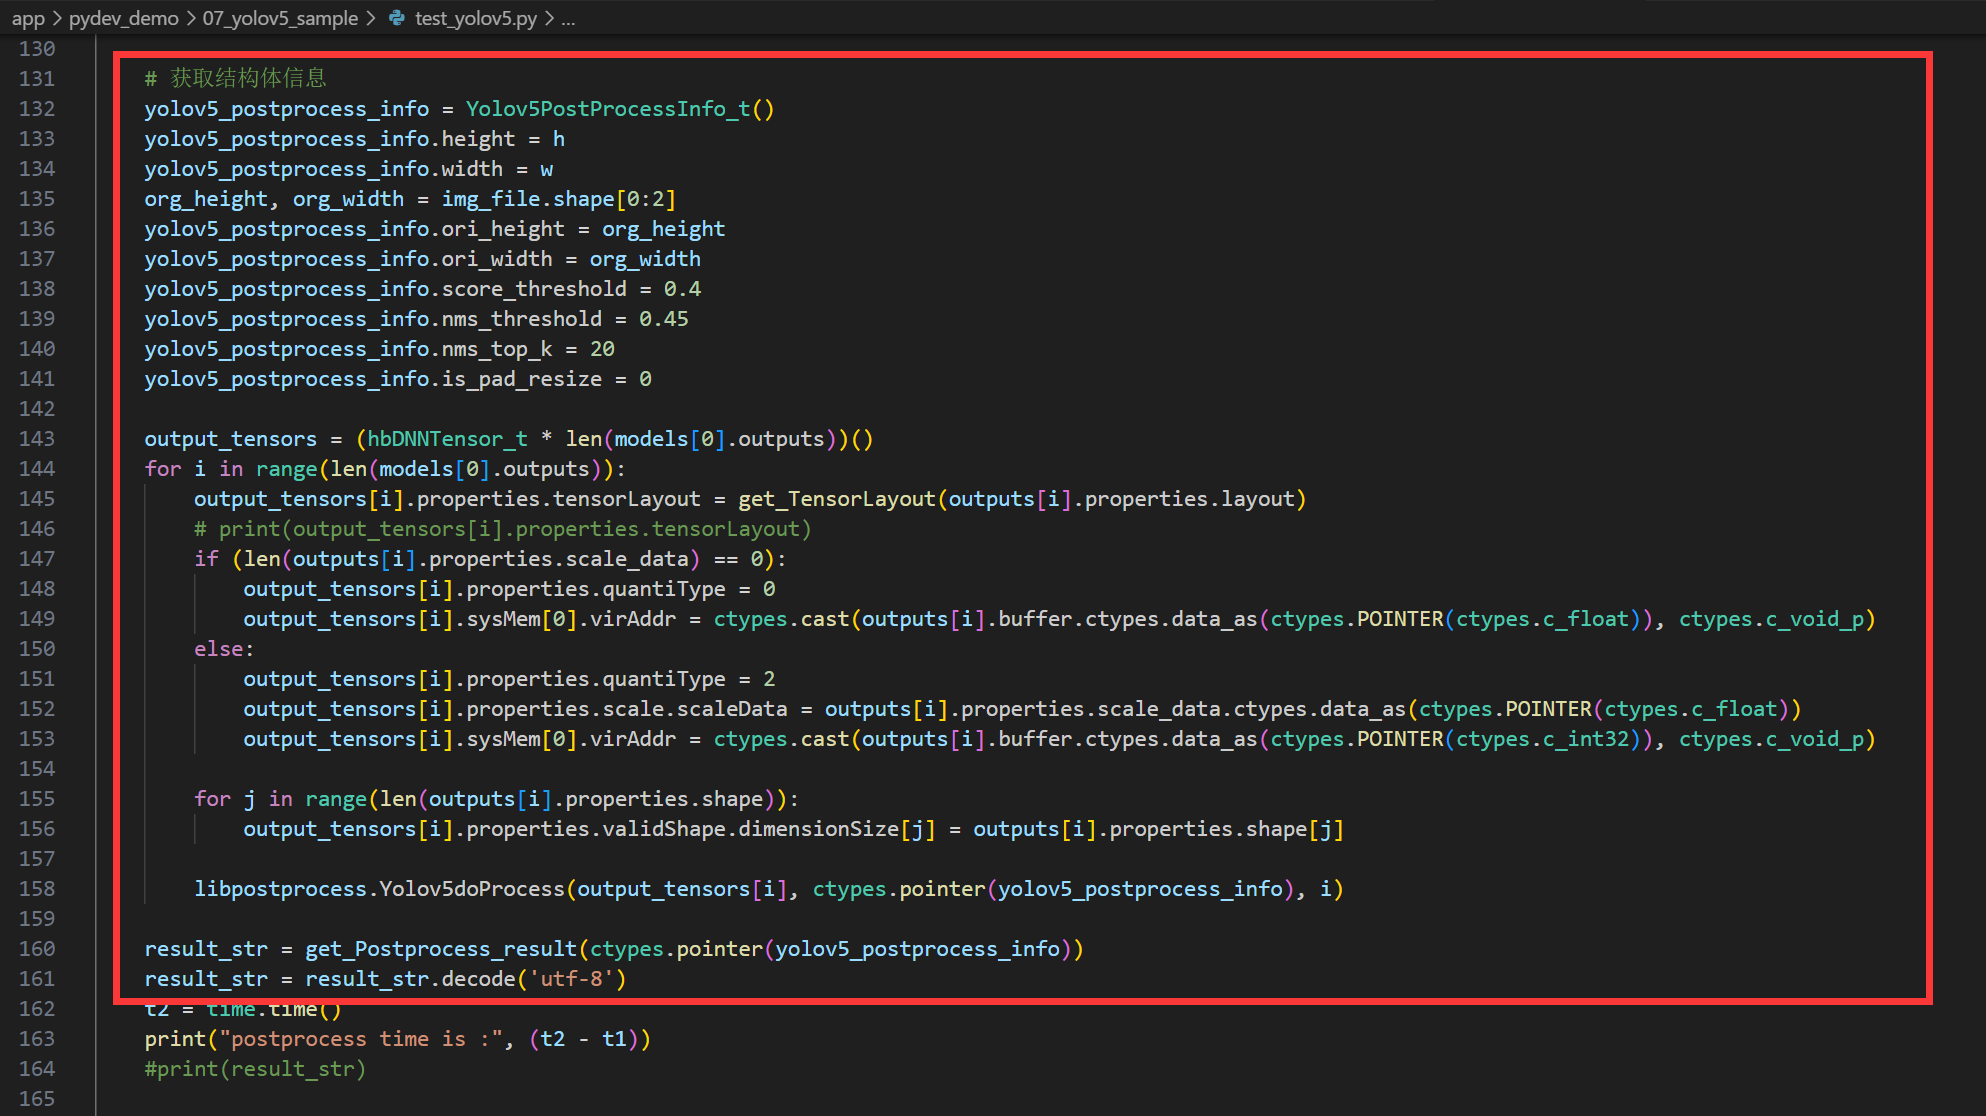
显然RDK官方也意识到了这个问题,很快就安排了新的后处理算法,是基于C++的,但是我尝试运行了一下,发现后处理速度确实有很大提高,在RDK X5上大约24ms左右,现在复盘一下可以知道这并不是极限,估计是内部的算法逻辑还没有得到极限优化。-
并且这个算法是Python的ctypes调用板卡上的/usr/lib/libpostprocess.so这个动态链接库使用的,API适配和类型转换的步骤极其繁杂,稍有不慎就会报错。-
2.3.Model_Zoo后处理算法Demo
Model_Zoo中的YOLOv5后处理示例应该是目前性能最优的,后处理可以在RDK X5上跑到3ms左右,包含模型格式检查等防错措施,算法逻辑也优化到了极致(后面会解释),这里附上Github链接:Model_Zoo:YOLOv5。-
不过Model_Zoo的这个后处理算法是单核心运算,Python也无法直接调用。
2.4.本算法
因此我希望能编写一个具有以下特点的yolov5后处理算法:
快:除了利用C++运算比Python快的优势外,再使用C++多线程(Python多线程无法并行运算)充分利用CPU资源加速计算,同时优化算法结构,从逻辑运算上加速后处理运算。易:RDK新版demo可能要结合ROS才能有比较好的使用效果,而Model_Zoo中纯C++后处理又需要配合C++的模型推理API使用,本算法面向RDK的纯Python用户,不了解原理也可以轻松使用。雅:每个开发者都追求令自己的算法逻辑清晰、性能稳定、风格明显并且详略得当,简单来说,我尽量让代码变得“优雅”。
三、YOLOv5快速后处理算法的优化
3.1.普通流程
YOLOv5后处理普通流程如下:-
3.2.优化1:一维索引跳过reshape与transpose
reshape操作可以改变张量的形状而不会改变数据的排布,在第一个reshape后数组的形状为[Batch x Weight x Height x Channel x 85],可以看出来数据的排布方式如下图所示:-
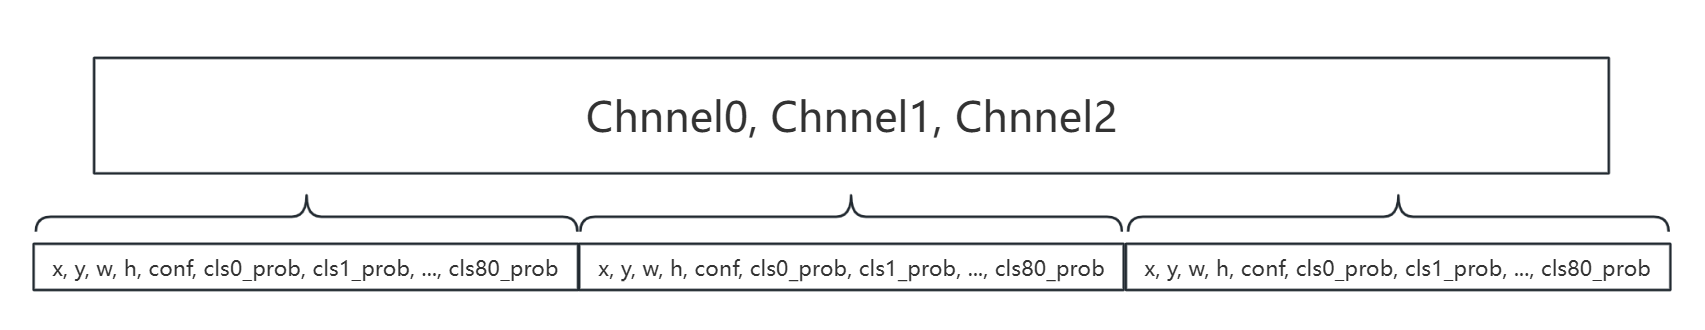
此时可以用一维索引多维的方法,来直接跳过
reshape过程,在模型内部需要reshape是为了模型对齐形状,而在后处理中就不需要考虑这些,能够拿到数据即可,在Channelx85这2个维度上:
index = index_Channel * 85 + index_Data
在全维度上:
index =
        index_w * (H * C * 85) +
        index_h * (C * 85) +
        index_Channel * 85 +
        index_Data
相反,也可以用求余操作来将一维索引值转化为多维索引。-
完成这一步后,所谓的transpose也只需要简单宏定义替换一下变量名称即可实现。
3.3.优化2:阈值反激活与预筛选
进行数据解码前,需要先将boxes的所有数据Sigmoid激活后再进行计算,而实际上YOLOv5后处理中最耗时的部分就是这大量数据的sigmoid操作,这也是RDK旧版Python后处理算法Demo耗时的主要原因。-
显而易见,Sigmoid具有单调递增性,且值域为(0,1),我们可以进行预筛选,不激活数据,先将box的最大类置信度求出,然后再对这个值激活,与激活后的框置信度相乘得到得分score,再与得分阈值进行对比,未通过阈值筛选的box就跳过,这样直接将Sigmoid的使用量缩小到了原来的2/85多一些。-
但我还有计算量更小的操作,由于Sigmoid是单调函数,可以求得其完备的反函数,我们可以将设定的得分阈值进行反激活,如果未激活的框置信度或者未激活的最大类置信度小于这个反激活阈值,就跳过。主要思想为:
- 若:
未激活的框置信度<反激活阈值, - 由于:0 < Sigmoid(x) < 1,且Sigmoid函数单调递增,
- 则有 Sigmoid(
未激活的框置信度) < Sigmoid(反激活阈值),即框置信度<得分阈值, - 于是
得分阈值>框置信度>框置信度x Sigmoid(未激活的最大类置信度) =置信度得分, - 反之也可以由
未激活的最大类置信度<反激活阈值推出相同结论。-
利用这一思想,做了预筛选后再对通过筛选后的box进行解码,能够大量节省Sigmoid函数的使用量,在板卡上的Demo模型与图片的例子中,Sigmoid的使用量由25200x6节约到了约2000个左右,也就原先的0.7%左右。
3.4.优化3:多线程阈值筛选
将25200个box切片,并分别放入C++的多线程中进行遍历预筛选,这一操作主要也能节约不少用时间,不过这一优化点的难点在于:
- 可变线程数的要求:由于
25200个box是由3个尺寸不同的boxes划分而成的,因此对每个线程的box切片策略需要慎重考虑,防止数组越界。 - 防止资源竞争:每个分线程筛选通过的数据最后都需要装入同一个容器,那就必须面对多线程计算最深刻的问题:资源竞争,我没有使用多线程的互斥锁,因为这样会导致程序中有过多的等待操作,增加无意义耗时,我使用了原子操作更新输出数组的索引值优化这个操作。-
实际上,优化2:阈值反激活与预筛选已经将后处理耗时优化到了几毫秒,这里多线程的优化效果不明显,选择合适的线程数的话大概还能再节约1-2ms左右,过小的线程数加速效果不明显,过大的线程数会增加线程调度资源成本,无法加速。
四、代码实现
放入全部代码的话过于冗余,在这里展示代码几个比较重要的点,所有代码可在Github仓库Horizon_yolov5_tools免费获取。
4.1.头文件:RDKyolov5postprocess.hpp
C++快速后处理函数的主要内容。
#ifndef RDKYOLOV5POSTPROCESS_HPP
#define RDKYOLOV5POSTPROCESS_HPP

class RDKyolov5postprocess{
    private:
        // 常量
        const int stride[3] = {8, 16, 32};
        const int anchors[3][3][2] = {10, 13, 16, 30, 33, 23, 30, 61, 62, 45, 59, 119, 116, 90, 156, 198, 373, 326};
        // 接收参数
        int model_size;     // 模型尺寸
        int classes_number;    // 类别数量
        float score_threshold; // 得分阈值
        float nms_threshold;   // NMS阈值
        int thread_num;        // 线程数
        // 内部计算参数
        float deactivate_score; // 反激活得分阈值
        int boxes_num[3];       // 3个输出头的box数
        int sub_box_num;        // 子线程任务box数
        int end_box_num;        // 尾线程任务box数
        int dboxes_num;         // 解码容器计数器
        float* decode_boxes;    // 解码容器
        int* nms_list;          // NMS标识列表
        int vim_num;            // 目标数量

    public:
        RDKyolov5postprocess(
            int model_size,     // 模型尺寸
            int classes_number,    // 类别数量
            float score_threshold, // 得分阈值
            float nms_threshold,   // NMS阈值
            int thread_num);       // 线程数

        int process(
            float* boxes0, // 3个box指针
            float* boxes1,
            float* boxes2);

        void score_filter(
            float* boxes0,   // 3个box的地址
            float* boxes1,
            float* boxes2,
            int begin_index, // 开始过滤的首索引
            int filter_len); // 过滤长度

        void get_results(
            float* results);

        ~RDKyolov5postprocess();
};

#endif
RDKyolov5postprocess::RDKyolov5postprocess: 构造函数void RDKyolov5postprocess::process: 后处理函数int RDKyolov5postprocess::score_filter: 得分筛选与解码函数,用于多线程计算服务void RDKyolov5postprocess::get_results: 获取结果RDKyolov5postprocess::~RDKyolov5postprocess: 析构函数
4.2.Cython接口处理:__postprocess__.pyx
将C++ API包装转换到Python API,同时也简化了函数使用。
cdef class yolov5postprocess:
    cdef RDKyolov5postprocess* c_obj

    def __cinit__(
        self,
        model_size,
        classes_number,
        score_threshold = 0.4,
        nms_threshold = 0.45,
        thread_num = 4
        ):
        self.c_obj = new RDKyolov5postprocess(model_size, classes_number, score_threshold, nms_threshold, thread_num)

    def __dealloc__(self):
        del self.c_obj

    def process(self, outputs):
        results_lenth = self.c_obj.process(
            <float*>cnp.PyArray_DATA(outputs[0].buffer.reshape(-1)),
            <float*>cnp.PyArray_DATA(outputs[1].buffer.reshape(-1)),
            <float*>cnp.PyArray_DATA(outputs[2].buffer.reshape(-1)))
        results = np.zeros((results_lenth,6), dtype=np.float32)
        self.c_obj.get_results(<float*>cnp.PyArray_DATA(results))
        return results
yolov5postprocess.__cinit__: 构造函数。yolov5postprocess.__dealloc__: 析构函数。yolov5postprocess.process: 后处理函数。
END
经测试,新的YOLOv5后处理工具在RDK X5上大约能跑到3-7ms左右,对比一下最初的300ms,真的是提升了非常多。-
希望这个项目能够帮助更多开发者在应用中实现高效模型推理。欢迎大家访问GitHub仓库,进一步探索和使用,共同推动开源社区的发展。
