您好,我在编译一个encoder模型,他的yaml如下
# encoder config
calibration_parameters:
  cal_data_dir: ./calibration_data_dir_cup/encoder_inputs/input_ids;./calibration_data_dir_cup/encoder_inputs/attn_mask_2d;./calibration_data_dir_cup/encoder_inputs/token_type_ids;./calibration_data_dir_cup/encoder_inputs/imgs;./calibration_data_dir_cup/encoder_inputs/depths;./calibration_data_dir_cup/encoder_inputs/pixels;./calibration_data_dir_cup/encoder_inputs/projection_mat_inv;./calibration_data_dir_cup/encoder_inputs/hist_robot_state;./calibration_data_dir_cup/encoder_inputs/joint_scale_shift;./calibration_data_dir_cup/encoder_inputs/joint_mask;./calibration_data_dir_cup/encoder_inputs/joint_relative_pos
  quant_config: {
    "model_config": {
      "all_node_type": "int16"
    }
  }

compiler_parameters:
  advice: 0
  balance_factor: 0
  cache_mode: enable
  cache_path: 'cache'
  compile_mode: latency
  core_num: 1
  jobs: 64
  max_time_per_fc: 0
  optimize_level: O2

input_parameters:
  input_layout_train: NCHW;NCHW;NCHW;NCHW;NCHW;NCHW;NCHW;NCHW;NCHW;NCHW;NCHW
  input_name: input_ids;attn_mask_2d;token_type_ids;imgs;depths;pixels;projection_mat_inv;hist_robot_state;joint_scale_shift;joint_mask;joint_relative_pos
  input_shape: 1x14;1x14;1x14;1x4x3x256x320;1x4x1x256x320;400x1x2;1x4x4x4;1x1x14x8;1x14x2;1x14;1x14x14
  input_type_rt: featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap
  input_type_train: featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap;featuremap
  mean_value: ''
  scale_value: ''
  separate_batch: false
  std_value: ''


model_parameters:
  debug_mode: ''
  march: nash-e
  onnx_model: test_onnx_model_cup/full_encoder_e2e1.onnx
  output_model_file_prefix: encoder_opt
  output_nodes: ''
  remove_node_name: ''
  remove_node_type: Quantize;Dequantize;Cast;Softmax
  # remove_node_type: Quantize;Dequantize
  working_dir: ./model_output_calib_encoder_cup1
在3.2.0的OE和gpu docker下正确,但是3.7.0的OE和cpu docker报错
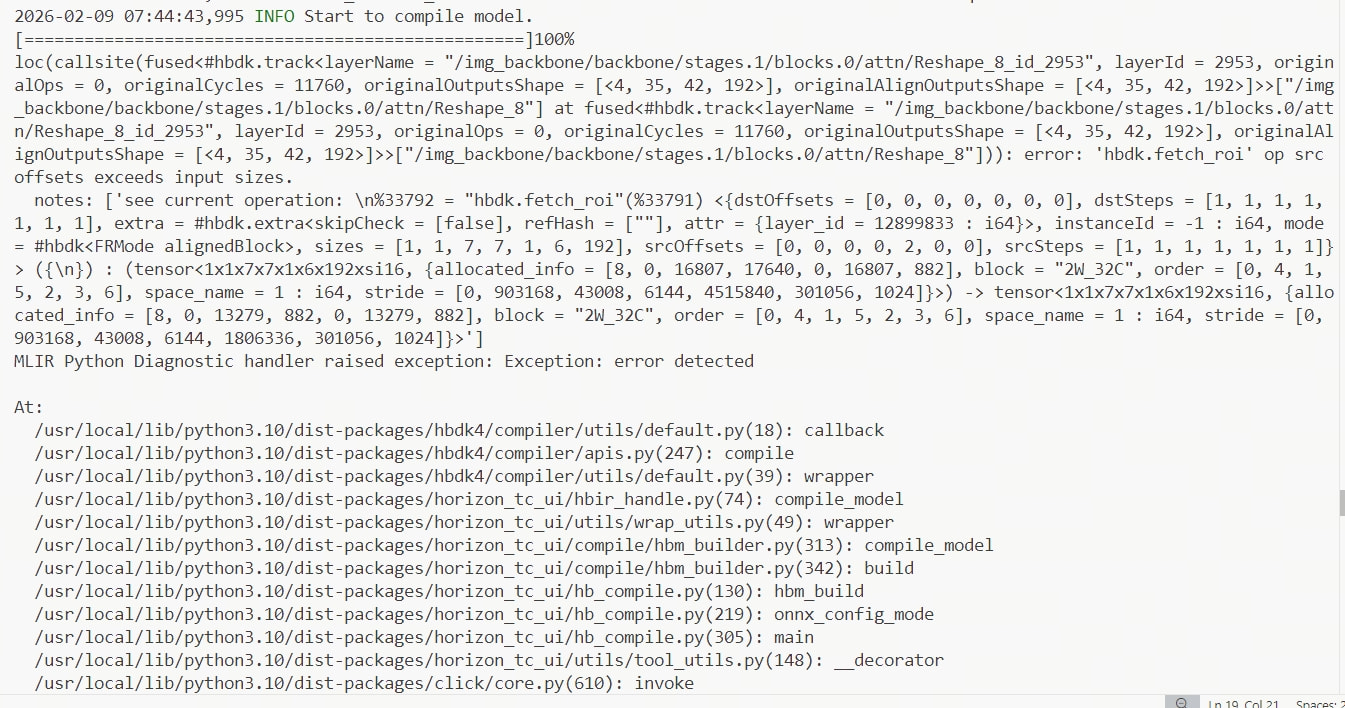
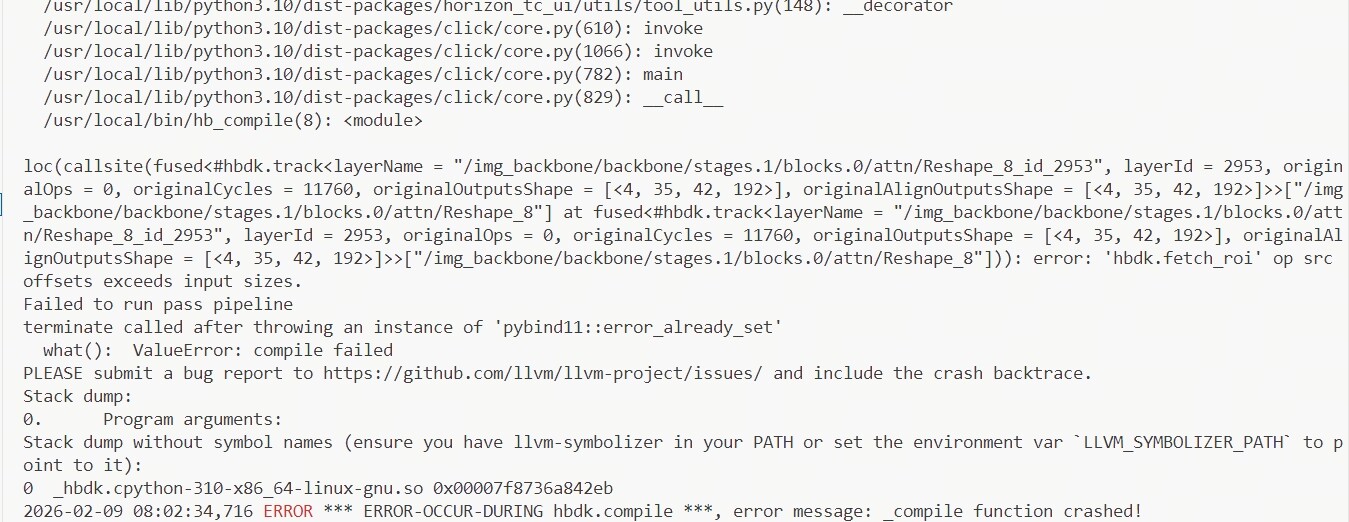
麻烦看下是什么情况 十分感谢,由于开发机只支持到cuda12.2,3.7.0的GPU Docker需要12.4以上的cuda,所以只用了cpu,有最新支持cuda12.2的gpu docker等资料也麻烦分享下,十分感谢