语音识别模型要真正部署到端侧,训练好浮点权重只是第一步。音频特征、模型导出、校准数据、BPU 子图和文本后处理必须使用同一套约定。
这次分享的 RoboGo 镜像,把 FunASR Paraformer、RDK Model Zoo、RoboGo 和 OpenExplorer 连成一条可以操作的技术链路:
RoboGo 数据管理中的语音与标注
            ↓ 读写挂载到 /personal
FunASR Paraformer 浮点微调与在线识别
            ↓
RDK Model Zoo 固定形状 ONNX 导出、三段切分
            ↓
真实语音校准 → OpenExplorer INT16 量化与 HBM 编译
            ↓
RDK S100 板端识别、精度与性能验证
训练检查点、日志、ONNX、量化报告和 HBM 输出到用户挂载的数据目录,可直接在 RoboGo 数据管理中查看和下载。Web 工作台提供中文操作界面,默认端口为 7860。
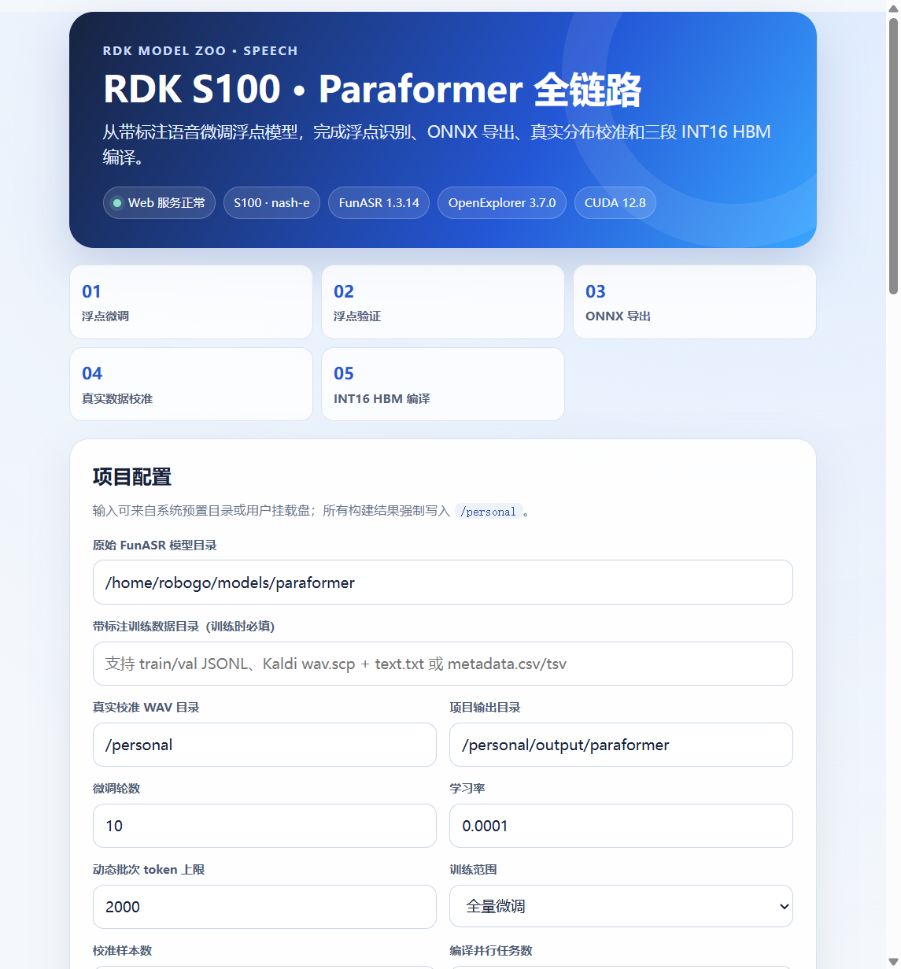
图 1 浮点微调、浮点验证、ONNX 导出、真实校准和 HBM 编译集中在一个页面。
为什么选择 Paraformer
Paraformer 是非自回归语音识别模型,适合把语音转成文字,并能在预训练模型基础上使用业务语音继续微调。对于 RDK S100,它的部署路线也很有代表性:既包含适合交给 BPU 的神经网络计算,又包含需要留在 CPU 的音频特征和 CIF 处理。
本镜像预置中文 Contextual Paraformer。用户可先用一条 WAV 验证浮点识别,再决定是否用自己的标注数据微调。模型量化沿用 S 系列 Model Zoo 的固定形状配方:Encoder、Predictor、Decoder 分别导出和编译,最终生成三个 S100 nash-e 的 INT16 .hbm。
目前单条音频的固定输入为 [1,400,560],约对应 24 秒音频,最长输出 100 token。更长的录音需要先切片或在业务侧使用合适的流式方案。
Model Zoo、RoboGo 和 RDK 分别解决什么问题
| 环节 | 作用 |
|---|---|
| FunASR | 提供 Paraformer 预训练模型、浮点识别和带标注语音微调 |
| S 系列 Model Zoo | 规定固定输入、ONNX 图处理、三段切分以及与板端推理一致的前后处理 |
| RoboGo 数据管理 | 保存语音、标注、训练日志和模型产物,并挂载到开发机 /personal |
| RoboGo 开发机与本镜像 | 提供 GPU 训练、Web 工作台、真实数据校准和 OpenExplorer 编译环境 |
| RDK S100 | 运行最终 HBM,验证真实语音上的识别效果、精度和时延 |
Model Zoo 在这里连接了浮点框架和板端代码。它约束导出形状、子图边界和中间张量含义,让训练产物可以沿着同一套配方走到 BPU。
可以直接使用的镜像
RDK S100 Paraformer 全链路镜像 v1.0
镜像固定了 FunASR 1.3.14、PyTorch 2.6.0、OpenExplorer 3.7.0 和 S100 nash-e 的构建路线。它与视觉镜像独立,后续更新语音环境时不会迫使 YOLO 或 PaddleOCR 用户一起重建开发机。
当前 Web 支持浮点模型在线识别和三段 HBM 编译。页面暂不提供 HBM 在线推理;编译成功后的识别效果、精度和性能需要到 RDK S100 板端验证。
5 分钟开始体验
1. 创建开发机
从上面的镜像链接创建开发机。推荐 1×RTX 4090 或同等级 NVIDIA GPU,系统盘至少 120 GB、推荐 200 GB;用户挂载盘建议预留 30 GB 以上,并以读写方式挂载到 /personal。
Web 应用填写端口 7860、路径 /。开机后先在开发机终端执行 bash /home/robogo/START_PARAFORMER_WEB.sh start,再点击“Web应用”;若仍显示 502,稍等片刻后刷新。默认输出目录为 /personal/output/paraformer,运行产物会回到 RoboGo 数据管理。
2. 先做一次浮点在线识别
工作台已经预置 Model Zoo 的样例 WAV。选择音频后点击“运行浮点识别”,确认模型、语音格式和词表正常。源开发机验收时,样例输出为“广州市房地产中介协会分析”。
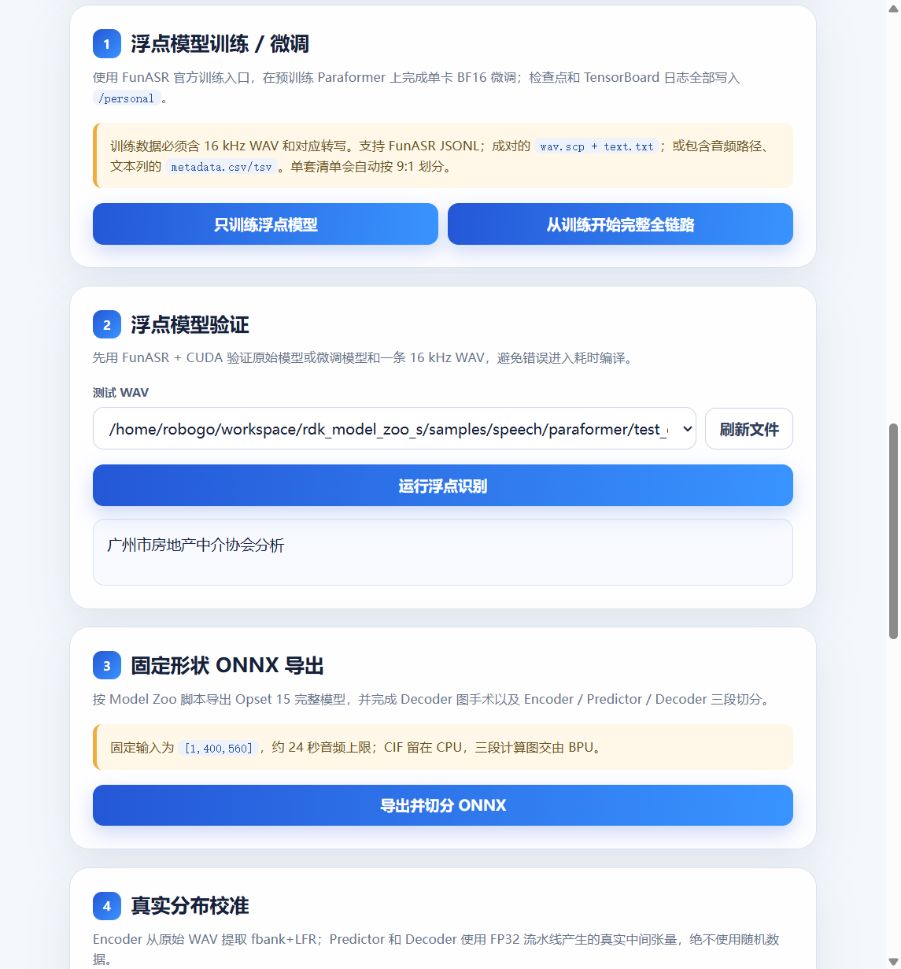
图 2 先确认浮点模型能识别真实 WAV,再进入耗时更长的导出和量化。
3. 已有浮点模型:直接导出和量化
如果已经有兼容的 FunASR 模型目录,可以跳过训练。在项目配置中指定模型和真实校准 WAV 目录,按顺序执行“导出并切分 ONNX → 生成全部校准数据 → 开始三段量化编译”,也可以使用完整全链路按钮。
三段模型的校准输入各不相同:Encoder 从原始 WAV 提取 fbank + LFR;Predictor 使用 Encoder 的真实 FP32 输出;Decoder 使用 Predictor 与 CPU CIF 产生的真实中间张量。用户只需提供原始语音,页面会自动准备后两段的校准数据。正式量化建议至少使用 50 条覆盖真实业务分布的单声道 16 kHz WAV。
WAV → fbank + LFR → Encoder(BPU) → Predictor(BPU)
                                  ↓
                              CIF(CPU)
                                  ↓
                             Decoder(BPU) → 文本
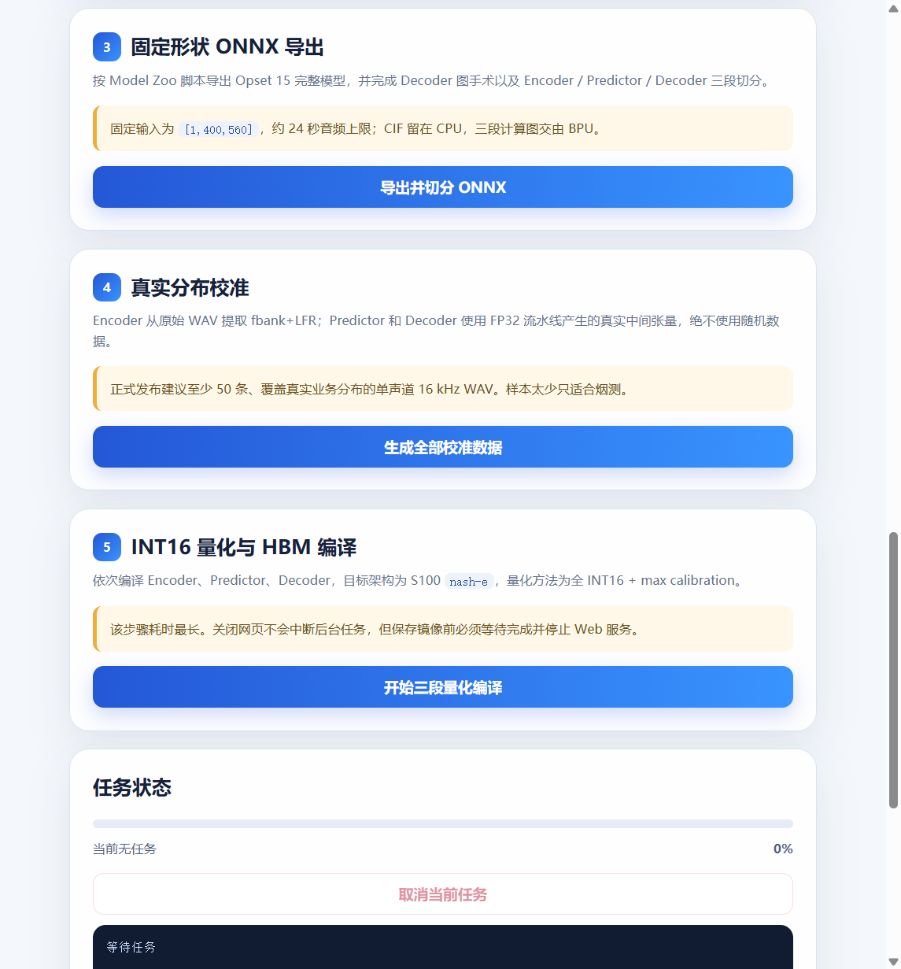
图 3 依照 Model Zoo 配方生成真实校准数据,再编译三个 INT16 HBM。
4. 使用自己的数据训练
如果要适配业务语音,先提供 16 kHz WAV 及对应文字。工作台支持 FunASR train.jsonl + valid.jsonl、Kaldi 风格 wav.scp + text.txt,以及包含音频路径和转写文本列的 metadata.csv/tsv。只有一套清单时会自动按 9:1 划分训练集和验证集。
页面提供全量微调和冻结 Encoder 两种范围,训练使用单卡 BF16。训练结束保留可断点续训的检查点、供导出使用的精简浮点模型和 TensorBoard 日志。第一次使用自己的数据时,建议先完成训练与浮点识别,再启动量化。
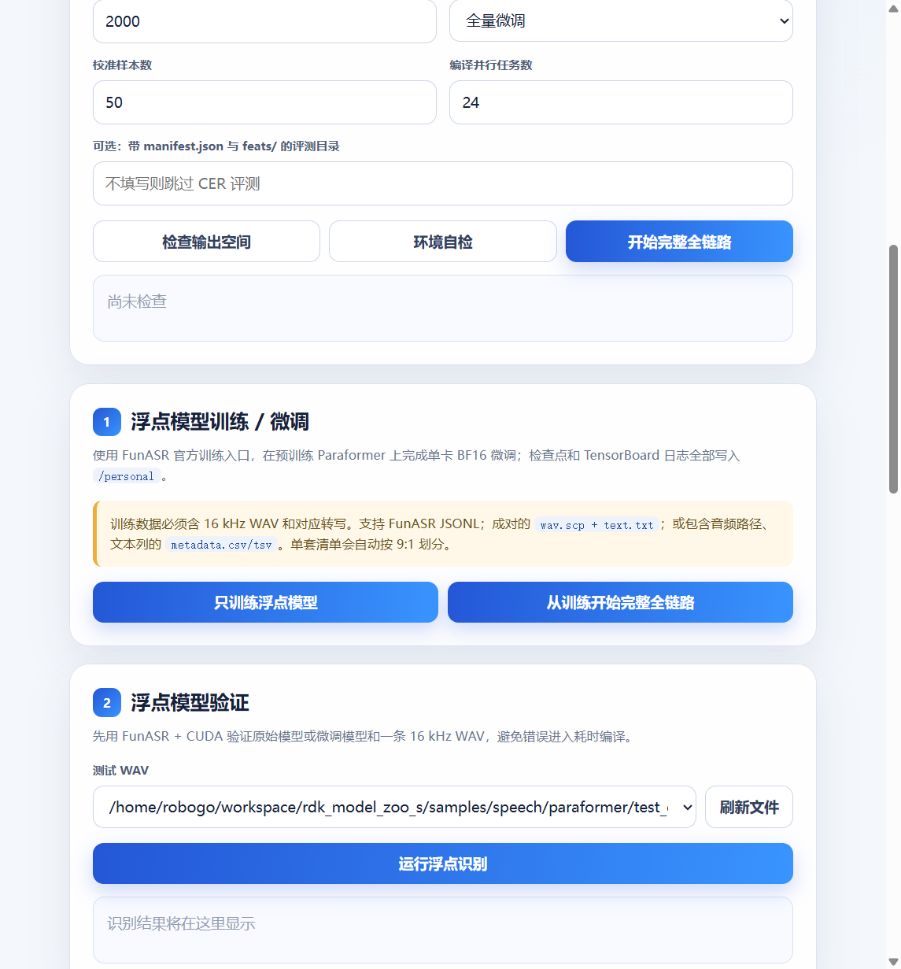
图 4 填写标注目录和训练参数后,可只训练浮点模型,或从训练开始执行完整链路。
怎样判断量化模型是否可靠
开发机上的检查包括:浮点 WAV 识别、固定形状 ONNX 与三段切分、真实分布校准数据、三个 HBM 产物和 OpenExplorer 构建日志。源开发机已跑通单卡 BF16 微调回载、完整 ONNX 导出、真实校准数据生成以及三段 INT16 HBM 编译。
开发阶段也用脚本对 FP32 和 INT16 PTQ ONNX 做过小样本流水线烟测,但那不是 HBM 推理,更不能据此给出板端精度或时延结论。因此 Web 只保留浮点在线验证;最终验收请在 RDK S100 上运行三个 HBM,并使用独立、具有代表性的业务验证集测量识别效果、CER 和时延。两条样例的烟测数值不作为正式精度指标。
常用恢复命令
Web 未正常打开时,在开发机终端执行:
bash /home/robogo/START_PARAFORMER_WEB.sh
检查环境或进入 Model Zoo:
source /home/robogo/bin/paraformer-env
paraformer-check
cd /home/robogo/workspace/rdk_model_zoo_s/samples/speech/paraformer
请完整保留同一次任务生成的浮点检查点、词表、ONNX、三个 .hbm、量化报告、YAML 和构建日志。欢迎在评论区反馈训练数据格式、浮点识别、ONNX 导出、量化构建及板端部署问题,我们会继续完善语音模型从训练到 RDK 部署的体验。