使用X5开发板,双目mipi相机模组,有没有其他深度估计模型,轻量化的,官方提供的深度估计模型 bpu使用占50%-60%,太高了,然后fps只有8
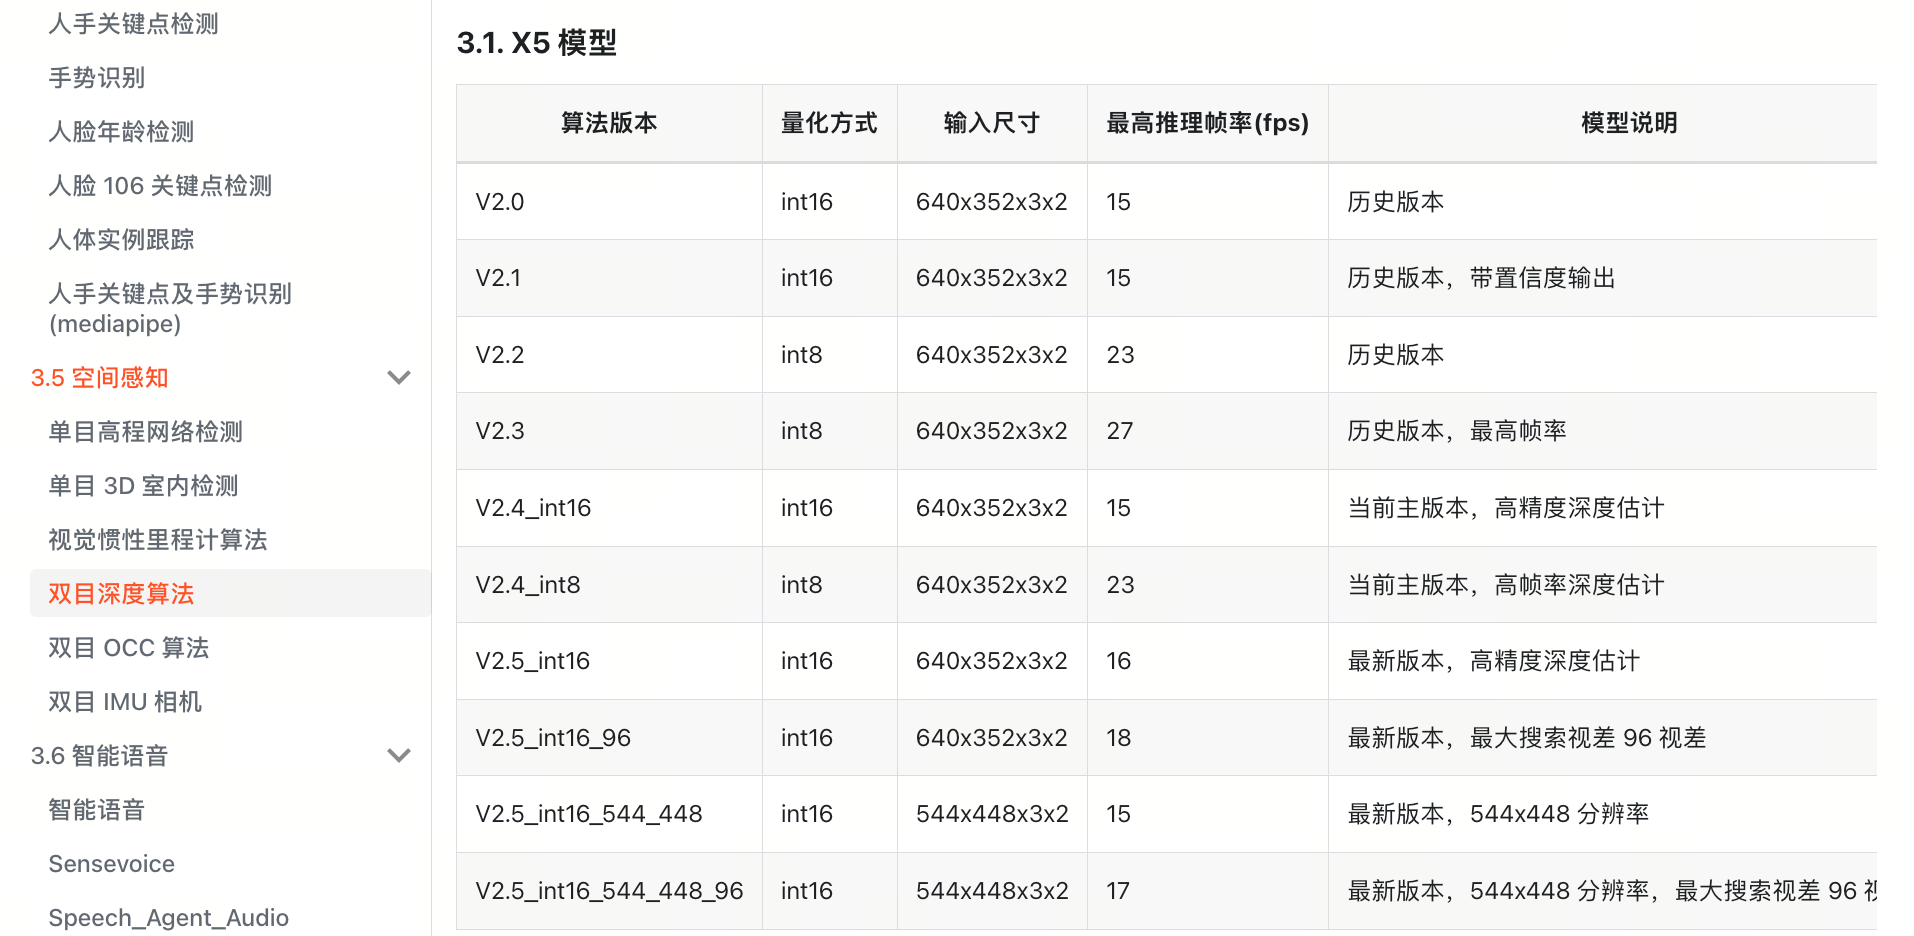
X5 上的双目深度模型就是官方这一套 StereoNet(IGEV/GRU 架构),没有另一套更小的网络;能“轻量化”的就是同一网络的编译版本差异。按官方《双目深度估计》文档(双目深度估计 | RDK X5 Magicbox ),X5 当前主版本是 V2.4_int16(640x352x3x2,15fps)和 V2.4_int8(640x352x3x2,23fps),文档默认就跑 v2.4_int8,也就是 int8 那版已是最省算力的;上面回复里那张表里的 544x448、96 视差搜索的 V2.5 系列只会更重。切换是在启动参数/launch 里选模型,例如 Magicbox 下:
bash app/ros_ws/src/magicbox/hobot_stereonet/script/run_stereo.sh \
  --mipi_rotation 0.0 --stereonet_version v2.4_int8 \
  --camera_info_topic /image_combine_raw/right/camera_info
本机实际有哪些型号直接列目录确认(换成对应 TROS launch 即可):
ls /opt/tros/humble/share/hobot_stereonet/config/ /opt/tros/humble/share/hobot_stereonet/launch/
不过你给的这两个数字值得先分辨:BPU 只占 50%–60%,说明现在压住帧率的不是 BPU 算力,单纯换个模型未必能把 8fps 拉上去。StereoNetNode 每帧都会打印 fps / cpu_usage / bpu_usage,先看这三项和日志里加载的 .bin 文件名——如果 bpu_usage 已接近满、fps 仍低,换 int8 或小输入版本才有意义;如果反而是 cpu_usage 高、BPU 有余量,瓶颈在采集/缩放/校正/后处理和 web 渲染链路,调模型收益很小。
把你启动命令里的模型型号和那行 fps/cpu_usage/bpu_usage 日志贴一下,我判断是模型还是链路的问题。若确实要更小更快的双目网络,只能自己用工具链训练、量化一个(HAT 有 StereoNet 训练流程,再用 PTQ 上板),官方没有再发布更小的现成模型。
官方这个版本训练数据是开源的吗,有做了哪些适配
我看有320x256的int16模型,有没有320x176的模型,为啥不是按照比例缩
训练数据:官方公开的是训练流程和公开数据集,不是板端那份 .bin 的训练数据本身。HAT 的 StereoNet 训练文档用的就是公开 SceneFlow 数据集(含 train/test 文件列表和 lmdb 打包步骤),配置在 configs/disparity_pred/stereonet/stereonetplus_mixvargenet_sceneflow.py。板端预置模型是否只用 SceneFlow、有没有叠加自采数据,文档没写,我这次能确认到的只有这套流程。
文档里明确写到的适配是输入格式和量化链路:训练图像一般是 RGB,而上板模型吃 YUV444,所以流程里加了 BgrToYuv444 数据增强;之后是 calibration/QAT 量化训练、导出定点模型再编译上板。尺寸方面,模型输入 shape 在编译时就固定,不存在把 640x352 等比缩放得到 320x176 这种派生版本。我这次检索到的官方 RDK X5 资料只明确 640x352 一档(V2.4_int16 15fps / V2.4_int8 23fps,默认 int8);你截图里的 V2.5、544x448、96 视差那几档,以及你说的 320x256 int16,不在我这次查到的官方页面里,所以先按“来源待确认”处理——方便的话把那页链接发我。
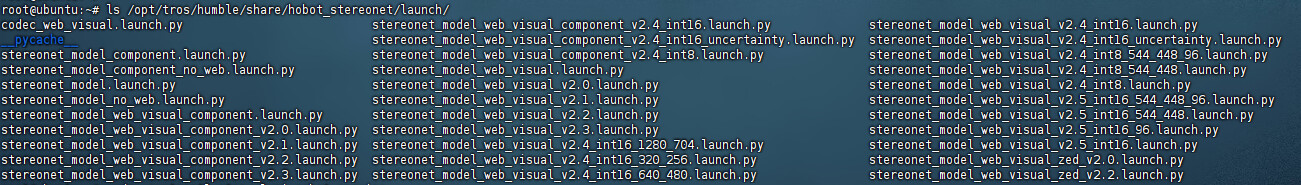
“有没有 320x176”我先在我们 X5 上把 hobot_stereonet 包内实际带的模型文件列出来核对,以文件清单为准,查不到就直说没有、不猜。你这台也可以先列一遍对比:
ros2 pkg prefix hobot_stereonet
find $(ros2 pkg prefix hobot_stereonet) -name '*.bin' | sort
文件名一般带分辨率和 int8/int16,贴出来就能看出你这版有哪些可选档位。
我这边板子里面有320256的,但是误差达到30cm,不够用,然后640352 fps 低和bpu 高
官方有int4的量化吗,
int4:没有。 我把本机已装的 tros-humble-hobot-stereonet 2.4.5 里所有模型列了一遍,又把官方源上更新的 2.5.6 包解包核对(只解包,没装到板上),这些 .bin/.hbm 的文件名标注只有 int8 和 int16,没有 int4 档;工具链侧范围也一样,大部分算子默认 int8,部分算子支持 int16/fp16(https://developer.d-robotics.cc/oe_s_doc/guide/ptq/ptq_faq_troubleshooting/ptq_faq)。所以“换 int4 把算力砍下来”目前没有现成模型可换。
320x176 也不存在。 全部档位里低分辨率只有 320x256(int16),内部模型名 DStereoV2.4.0_320_256,双目输入各为 1x3x256x320;再往上就是 640x352、544x448 这些,没有任何文件名或输入 shape 是 320x176。这也不是“该等比缩却没缩”:模型输入 shape 在编译时就固定,每一档是各自独立量化编译出来的模型文件,不存在从 640x352 派生一档的做法。想要这个尺寸只能按 HAT 的 StereoNet 流程自己训练后重新量化编译(https://developer.d-robotics.cc/oe_s_doc/guide/advanced_content/hat/examples/stereonet)。
8fps 不是 BPU 推理上限。 在这块 RDK X5(系统 3.5.0-beta、Ubuntu 22.04.5、kernel 6.1.83)上做纯 BPU 单模型计时(hrt_model_exec perf --thread_num 1 --frame_count 100,合成输入,不含采集/校正/后处理/编码):320x256 int16 约 29ms≈34fps,640x352 int8 约 45.5ms≈22fps、int16 约 65ms≈15fps,与官方双目深度文档标 X5 的 V2.4_int16 15fps / V2.4_int8 23fps 同量级(https://developer.d-robotics.cc/magicbox_doc/algorithm-development/stereo-depth)。官方源 2.5.6 包里还多一档 544x448、视差搜索 96 的 int8 模型,同条件下约 39.6ms≈25fps——输入比 320x256 大、BPU 比 640x352 int8 略轻,但这一档只存在于 2.5.x 的包里。你的 BPU 只占 50–60%,说明压住帧率的多半不是推理本身,而是采集/校正/后处理/编码渲染那段。
320x256 的 30cm 误差:分辨率降下来后,校正输出的等效焦距也跟着变小(本机跑 320x256 时节点日志里 rectified fx 约 192.6,跑 640x352 档约 257.9,具体数值取决于各自的 stereo.yaml 标定),同样的视差误差换算成深度误差会被放大;这一档的后处理走的是 v2.1。要分清是分辨率的固有代价还是标定不匹配,给两项就够:30cm 是在多少米处测的、误差随距离是等比例放大还是远处迅速变差;以及 stereo.yaml 里的 base_line 是否是你这块模组自己标定出的值。
换档位之前先对一下版本,启动名才能对上:dpkg -l | grep -i stereonet(2.4.x 的 launch 只到 v2.4_int16_320_256,544x448/96 视差那批要到 2.5.x 才有)。
BPU 不支持 int4 量化 ,目前交付的模型都在手册里面了
v2.4_int16模型版本为例 交付时测试下来 2m内误差小于3%
int4:没有。 本机 RDK X5 上装的 tros-humble-hobot-stereonet 2.4.5,包内深度模型文件名标注只有 int8/int16;官方 apt 源上更新的 2.5.6 我下载后只解包核对(没装到板上),里面 16 个 .bin + 3 个 .hbm 也一样只有 int8/int16,没有 int4 档。工具链侧口径一致:大部分算子默认 int8,部分算子支持 int16/fp16,本次公开资料里没有 int4 这一档(Rspress )。所以想靠 int4 降算力,目前没有现成模型可换。
320x176:也没有。 低分辨率档只有 320x256(int16),内部模型名 DStereoV2.4.0_320_256,双目输入各为 1x3x256x320;2.5.6 包里新增的是 640x480、544x448、1280x704 和 v2.5 系列,仍然没有 320x176。这也不是“该等比缩却没缩”:每档模型输入 shape 在编译时就固定,各自独立量化编译,不存在从 640x352 派生一档。要这个尺寸只能自己按 HAT 的 StereoNet 流程训练后再量化编译上板(Rspress )。
8fps 不是 BPU 上限。 在这块 X5 上做纯 BPU 单模型计时(hrt_model_exec perf --thread_num 1 --frame_count 100,合成输入,不含采集/校正/后处理/编码):320x256 int16 约 29ms≈34fps;640x352 int8 约 45.5ms≈22fps、int16 约 65ms≈15fps,与官方双目深度文档标 X5 的 V2.4_int16 15fps / V2.4_int8 23fps 同量级(双目深度估计 | RDK X5 Magicbox )。你 BPU 只占 50–60%,压住帧率的多半是采集/校正/后处理/编码渲染那一段,单换模型收益有限。
320x256 的 30cm 误差:分辨率降下来后校正输出的等效焦距也变小(本机标定文件下 rectified fx:320x256 约 192.6、640x352 约 257.9,具体取决于各自的 stereo.yaml),同样的视差误差折算成深度误差会被放大;且这一档后处理走的是 v2.1。要分清是分辨率的固有代价还是标定不匹配,给两项就够:30cm 是在多少米处测的、误差随距离是等比例放大还是远处迅速变差;以及 stereo.yaml 里的 base_line 是不是你这块模组自己标定出的值。
换档位前先确认你板上的包版本:dpkg -l | grep -i stereonet。我核对的 2.4.5 里档位到 v2.4_int16_320_256 为止,你截图里 V2.5 / 544x448 那批要到 2.5.x 的包里才有,以你板上这版自带的 launch 为准。
X5 上交付的双目深度就是 StereoNet 这一套的多档编译版本,没有第二个更轻的网络,也没有 int4、320x176 这两个档。
int4 没有:本机已装的 tros-humble-hobot-stereonet 2.4.5,以及官方源上的 2.5.6(只解包核对,没装到板上),模型文件名只有 int8/int16;工具链文档列的计算精度也只有 int8/int16/fp16(Rspress )。想靠 int4 砍算力,目前没有现成模型可换。
320x176 也没有:这两个包里低分辨率档只有 320x256(内部名 DStereoV2.4.0_320_256,每目输入 1x3x256x320),解析出的输入形状只有 640x352 和 320x256(2.5.x 另多了 640x480、544x448、1280x704),.bin/.hbm 文件名里也都没有 176。这也谈不上“该等比缩却没缩”:每档输入 shape 在编译时就固定,各自独立量化编译,不是从 640x352 派生;官方为什么挑 320x256 这个宽高比,公开资料没写。真要 320x176 只能按 HAT 的 StereoNet 流程自己训练再量化编译(Rspress )。
8fps 不是 BPU 上限:在这块 X5 上做纯 BPU 单模型计时(合成输入,不含采集/校正/后处理/编码):320x256 int16 约 29ms≈34fps,640x352 int8 约 45.5ms≈22fps、int16 约 65ms≈15fps,与官方文档标 X5 的 V2.4_int16 15fps / V2.4_int8 23fps 同量级(双目深度估计 | RDK X5 Magicbox )。BPU 只占 50–60% 说明它没跑满,换小一档模型只能省掉推理那一小段。
320x256 的 30cm 误差:分辨率降下来后校正输出的等效焦距也变小(本机 stereo.yaml 下 rectified fx:320x256≈192.6、640x352≈257.9,实际取决于你的标定文件),同样的视差误差折算成深度误差会被放大;这一档后处理走的是 v2.1。要分清是分辨率的固有代价还是标定不匹配,两项就够:30cm 是在多少米处测的、误差随距离是等比例放大还是远处迅速变差;stereo.yaml 里的 base_line 是不是你这块模组自己标定出的值。
你贴的 /opt/tros/humble/share/hobot_stereonet/launch 清单里有 v2.4_int16_320_256、v2.4_int16_640_480、v2.4_int8_544_448_96、v2.5_int16_544_448_96 这些——我们这边 2.4.5 包里没有,只在我们解包的 2.5.6 里见过,所以先确认你这版实际能选哪些档:dpkg -l | grep -i stereonet 和 ls /opt/tros/humble/share/hobot_stereonet/config/,顺手把启动用的那个 .bin 和节点日志里 fps / cpu_usage / bpu_usage 那行发出来。
有没有320x256的int8的,或者pth权重也行,刚刚30cm的误差是由于参数没对齐,现在误差挺小的,想用int8,int16资源占用还是挺大,
320x256 没有 int8 档。 官方文档给 X5 列的交付模型是 640x352 的 V2.4_int16 与 V2.4_int8(默认 int8,双目深度估计 | RDK X5 Magicbox );我们核对的 hobot_stereonet 2.4.5 已装包和 2.5.6 解包包内,320x256 也只有 int16 一个(模型名 DStereoV2.4.0_320_256),int8 只出现在 640x352 和 544x448_96 这两类上。你板上自己确认一次:
ls /opt/tros/humble/share/hobot_stereonet/launch/ | grep -E '320|int8'
pth 权重也没有公开。 HAT 的 StereoNet 教程是从 SceneFlow 从头训浮点模型 → calibration/QAT → 导出定点 → compile 成上板 hbm,这条链路没有提供板端预置模型对应的 pth(Rspress )。想在 320x256 上拿 int8,只能按这条流程自己训一版再编译,并且 int8 对深度精度的影响要在你们自己的场景实测,没有现成档位可对比。
“int16 占用大”要看是哪一段吃掉了时间。 320x256 int16 纯 BPU 单模型推理在这块 X5 上约 29ms/帧(≈34fps,合成输入,不含采集/校正/后处理/编码),这一档推理本身不像是瓶颈;若你现在跑的是 640x352 int16,BPU 占 50–60% + 8fps 的组合也说明推理没跑满。想用 int8 的话,你板上清单里除 640x352 外还有 int8 544x448_96 一档可以直接切(同档在解包的 2.5.6 里单模型计时约 39.6ms≈25fps)。把启动用的档位和节点日志里 fps / cpu_usage / bpu_usage 那行贴出来,就能判断换档有没有用。
板端320 256 的只有int16,因为我们模型多,然后x5又是单核的,39ms,对整体模型的平均等待时间太长了
320x256 没有 int8 档,预置模型的 pth 权重也没公开(官方 X5 交付表只列 640x352 的 V2.4_int16/V2.4_int8:双目深度估计 | RDK X5 Magicbox )。你现在只有 int16 这一档是正常的。按你说的情况(X5 单核 BPU、多个模型分时),先把 39ms 的口径和调度方式定下来,比换档位更值得。
换 int8 这条路在现成档位上基本没用。 你板子清单里的 int8 档只有 640x352 和 544x448_96,输入都比 320x256 大。我们在同样的 X5 上做纯 BPU 单模型计时(合成输入、thread_num 1,不含采集/校正/后处理/编码):320x256 int16 约 29ms,544x448_96 int8 约 39.6ms,640x352 int8 约 45.5ms。位宽降一半不等于单帧时间减半,这里决定耗时的是输入尺寸和视差搜索范围——为了压平均等待时间切这两档,很可能反而更慢。
能直接压等待时间的是调用策略:把深度估计从"每帧都跑"改成按需触发或降频,它的平均 BPU 占用会随调用频率成比例下降,代价是深度图更新率变低。若一定要 320x256 的 int8,只能自己训一版再量化编译(官方公开的是 HAT 的 StereoNet 训练流程 Rspress ,量化/编译走 X5 工具链 5.1. PTQ、QAT 简介 — D-Robotics Open Explorer ),int8 对深度精度的影响得在你们场景实测,没有现成对照。
两个信息确认一下:39ms 是节点日志/你们自己打点统计的,还是 hrt_model_exec perf 单跑这一个模型?现在多模型是同一进程串行调 BPU,还是各节点各自抢占?这决定该压推理时间还是压调用频率。
320x256 没有 int8 档,预置模型的 pth 也没公开,所以你板上只有 int16 是正常的:官方 X5 交付表只列 640x352 的 V2.4_int16(15fps)与 V2.4_int8(23fps,默认):双目深度估计 | RDK X5 Magicbox
想靠 int8 把这一次的 39ms 压下来,在现成档位里走不通。 你板上的 int8 档是 640x352 和 544x448_96,输入都比 320x256 大。我们在这块 X5 上做纯 BPU 单模型计时(合成输入、thread_num 1,不含采集/校正/后处理/编码):320x256 int16 约 29ms,544x448_96 int8 约 39.6ms,640x352 int8 约 45.5ms。这一档的耗时主要由输入尺寸和视差搜索范围决定,位宽降一半不等于单帧时间减半,切到那两个 int8 档只会更慢。
要压的是平均等待时间,能直接动的是调用频率。 把深度估计从"每帧都跑"改成隔帧或按需触发,它在整条多模型流水线里的平均占用大致随调用频率成比例下降,代价是深度图刷新率变低;如果你们的感知节拍本来就要求每帧拿到深度,那就得从别的环节省,而不是换模型档位。
两个信息确认一下再往下定:39ms 是节点日志/你们自己打点统计的整段耗时,还是 hrt_model_exec perf 单跑这一个模型?现在多个模型是同一进程串行请求 BPU,还是各节点各自抢占?这决定该压调用频率还是压单次耗时。