[问题分类] [算法工具链]
[板卡类型] [RDK S100]
工具 hrt_model_exec perf 在做bpu上面的profiling 的时候,其中的bpu 回变成一块。 如果想要看bpu里面每层的时延信息,是否有对应的工具?
[问题分类] [算法工具链]
[板卡类型] [RDK S100]
工具 hrt_model_exec perf 在做bpu上面的profiling 的时候,其中的bpu 回变成一块。 如果想要看bpu里面每层的时延信息,是否有对应的工具?
板端没有“BPU 内部逐层”的实测开关:在 runtime 图里 BPU 子图就是一个节点,所以 hrt_model_exec perf 和 --profile_path 出来的 profiler.csv 里,model_latency 是 OP 级(BPU 整体一条),processor_latency 只有 BPU_inference_time_cost 总计。逐层数据要看编译阶段生成的静态性能文件 model.html / model.json。
1)板端确认现有粒度(可与静态数据对照):
hrt_model_exec perf --model_file=your_model.hbm --thread_num=1 --profile_path="."
生成的 profiler.csv 中看 model_latency、processor_latency、task_latency,字段含义见 模型性能分析。
2)逐层 BPU 耗时:用 hb_compile 编译时会默认在 yaml 的 working_dir 下生成 model.html + model.json;已有 hbm 也可以调 hbm_perf("your_model.hbm", output_dir="./perf") 单独生成(导入方式见 HBDK API Reference)。打开 html 看两个选项卡:
Layer Details:每一层 BPU 算子的计算量、计算耗时、数据搬运耗时,以及编译后的 layer 活跃时间段;Timeline:一帧内指令级的预估耗时及对应单元(TAE/VAE/AAE/VPU/SPU/TRANS/LOAD/STORE)。依据见 性能评测及调优。
注意两点:model.html 是编译器静态预估,不是板上实测,和 perf 的端到端 latency 会有偏差;Layer Details 里“活跃时间段”也不等于该层执行时间,因为多层会交替/并行。若确实需要实测的逐层数据,只能把模型按层截断分别编译成多个 hbm 再 perf 比较增量,结果受调度和带宽影响,不能当作单层真实执行时间。另外 hrt_bpu_monitor/ucp_monitor 只能看 BPU 占用率,给不出逐层耗时。
你的 x86 端工具链和板端 SDK 是哪个版本?如果编译后 working_dir 里没有 model.html,多半是工具链版本或编译未走 PTQ 链路,需要按版本再确认。
如果你这个x86 模拟的测试,不能够跟板端对齐,建议提供一个板端的工具。否则这个之间的gap 怎么处理呢?
model.html 是编译产物的静态估算,不是在 x86 上跑了一遍推理,所以它和板端对不齐属于方法层面的差异,不是参数没调好。官方公开资料里,板端实测的最小粒度是 UCP 算子:runtime 图里整个 BPU 子图就是一个算子,perf 的 model_latency 也只能到这一层。
板端能往下挖的两条通道,见 UCP Trace 使用说明:
1)UCP 算子时间线(实测,算子粒度)
export HB_UCP_ENABLE_PERFETTO=true
hrt_model_exec perf --model_file=your_model.hbm --thread_num=1 --profile_path="."
用 Perfetto UI 打开生成的 ucp.pftrace,看 SubmitOp/OpInfer/OpFnish。它能区分模型推理任务里 BPU 子图与 CPU 算子/前后处理各占多少,但 BPU 子图内部仍是一条,不会拆成 conv1/conv2。
2)BPU 硬件 trace(system 模式,bputrace_period_ms 按负载调小),需在应用启动前开启:
echo 0 > /sys/devices/system/bpu/bpu0/power_enable
echo 1 > /sys/devices/system/bpu/bpu0/trace
文档要求其可视化使用 hbperfetto,需联系地瓜系统软件技术支持获取;文档未承诺它能细化到逐 layer 耗时。
gap 的处理,实用做法是把它当两类数据用,不强行逐层对齐:
Layer Details 只取相对占比,用来排序热点层;profiler.csv 的 processor_latency: BPU_inference_time_cost 作锚点,按「板端 BPU 总耗时 / Summary 预估 BPU 总耗时」对占比做一次整体缩放,得到单层估计值,仅用于横向比较;--thread_num=1,动态输入补 --input_valid_shape/--input_stride,并同时看 ucp_monitor 的 BPU 占用率与是否降频;perf 做差分,差分中会混入调度和带宽影响。板端逐层工具属于工具链能力诉求,公开资料里目前没有对应入口。如果是要按层做定点优化,或需要用到 hbperfetto,把模型结构、层数规模和这一步想解决的问题整理出来,可走 DGP 项目对接与技术支持 与 FAE 对接;是否提供、以什么形式提供需那边确认。
要核对缩放比,需要 profiler.csv 里的 BPU_inference_time_cost、model.html Summary 的预估 BPU 耗时,以及实际 perf 使用的输入参数。
您好,板端 perf 看到的是整个 BPU 子图的耗时,能测原模型每层耗时的入口的工具里未公开,如果要看差多少,可以试试拿同一个 HBM 的板端 BPU 耗时和静态报告里的 BPU 总耗时对照,逐层估算用来找热点
先把结论放前面:公开资料里没有板端逐层 profiling 工具。runtime 图里整个 BPU 子图就是一个算子,perf、UCP trace 能到的最小粒度都是它,没有把它拆到 conv1/conv2 的入口。所以这不是“等一个板端工具就能对齐”,而是在现有粒度上把两类数据分工用。
补充一个此前没提到的板端现成能力:hrt_model_exec perf 的 dump_intermediate(取值 0–3)可以在板上 dump 每层输入输出。它不给时延,但能把“哪些层被融合进同一个 BPU 子图”核实清楚——这决定 UCP trace 里能拆出几段,也决定静态报告里的层名能不能直接对到板端数据上。先做这一步,比继续争 gap 更有用。
gap 本身建议这样处理:
--input_file 或固定 --input_valid_shape/--input_stride)、--thread_num=1,同时确认没有降频和资源抢占。条件不一致时两个数不能相减。profiler.csv 的 processor_latency: BPU_inference_time_cost,除以 model.html Summary 的预估 BPU 总耗时,得到比值 k。换 2–3 个结构不同的模型各算一次:k 落在同一区间,说明静态模型在这类负载下没有明显漂移,可以用 k 统一缩放逐层占比来排序热点;k 分散得厉害(比如带宽受限层占比高时偏大),逐层占比仍可用于相对排序,但绝对值不可信。把 k 写进结论,比写“静态数据和实测有偏差”可复现。perf 做差分,结果会混入调度和带宽影响,只适合同条件横向比较。静态文件定位见 性能评测及调优,板端字段口径见 模型性能分析。
板端逐层工具是工具链能力诉求,公开资料没有对应入口,也不会在这里给排期。如果你的目的是按层做定点优化或定位某层异常,把模型结构、层数规模和要解决的问题整理后走 DGP 项目对接与技术支持 与 FAE 确认可用手段,论坛这边可以先按上面的口径把方案和数据理顺。
方便的话贴一下该模型的 dump_intermediate 结果或 profiler.csv 里 model_latency 的节点清单,能判断它是不是一个 BPU 子图,也就能确定 k 该怎么取。
是不是应该该有这个工具 ?
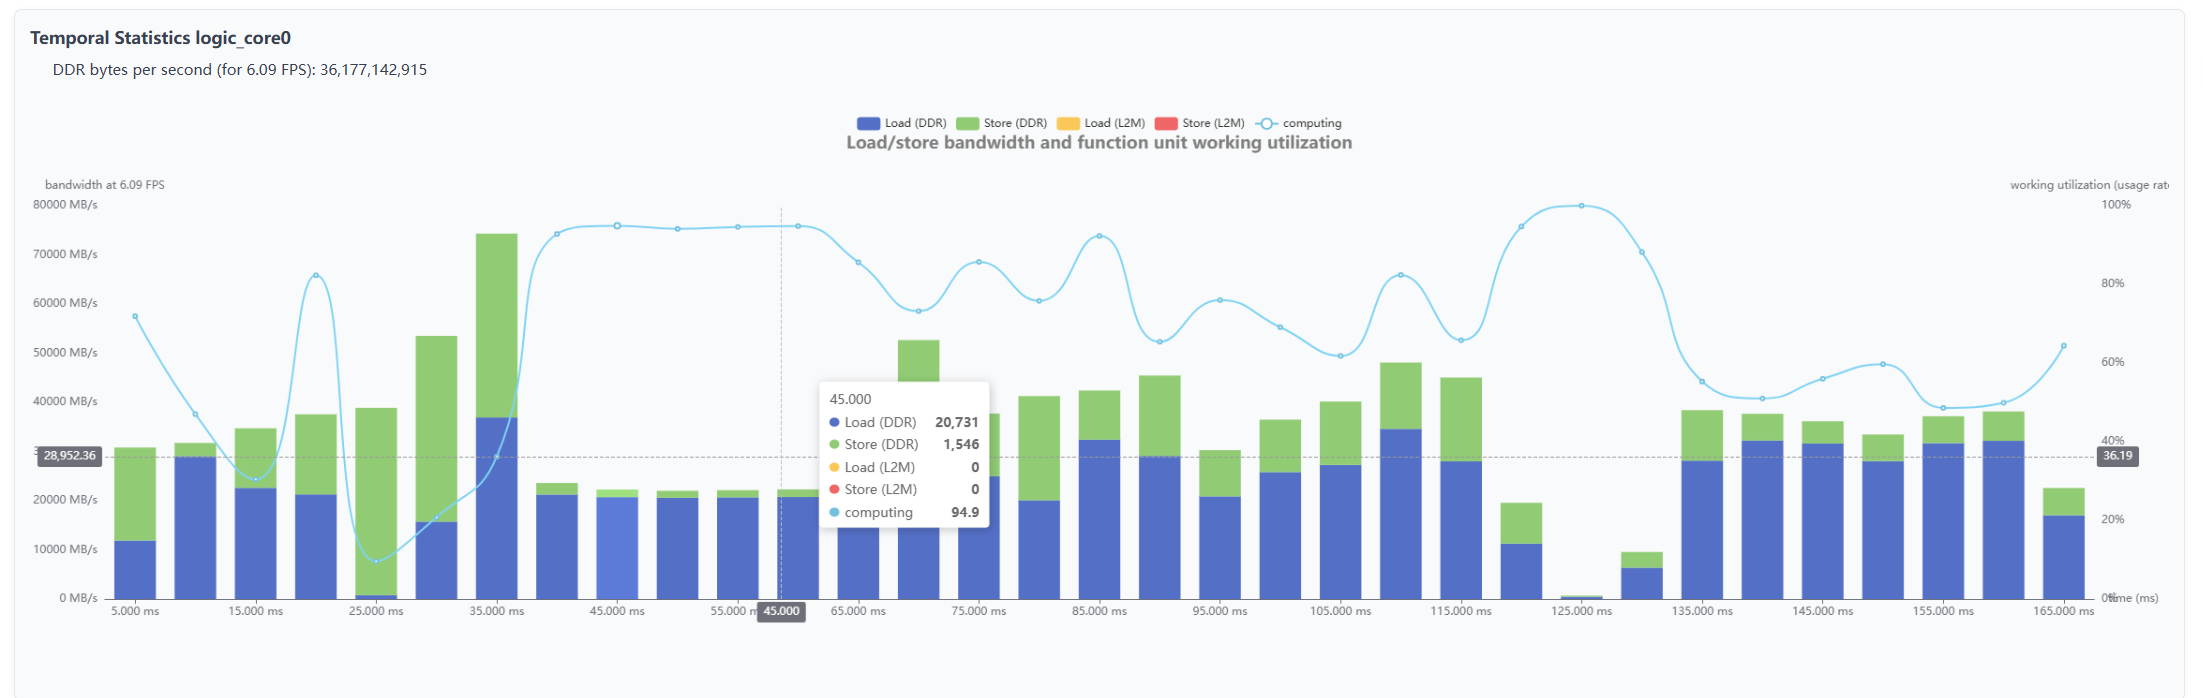
我查看了下x86 上面的静态估算的图, 貌似这个仅仅能够看到这个时间线上面的io,和计算的能力。 是因为我使用的方式不对么? 我想看到静态的的每次的分析,以及这个带宽的统计的话,按照LDPPR 的能力来统计这个峰值么? 还是NPU 和CPU 不同的U 间 ,带宽又是怎么划分的呢?
你截图的是 Temporal Statistics,它本来就不是逐层视图:这个选项卡只给“模型一帧推理时间内”的带宽占用和功能单元利用率随时间变化,横轴是时间,不是 layer,所以看到的是 IO 与计算能力的整体曲线。逐层数据在另外两个选项卡里:
四个选项卡的定位见 性能评测及调优。
关于带宽峰值口径:从你的图看,纵轴上限约 80,000 MB/s、峰值标注也在 80 GB/s 量级,与 S100 这颗 SoC 的 LPDDR5 理论值对得上——6400 MT/s × 96 bit = 76,800 MB/s,见 DDR 带宽测试 的“理论带宽计算公式”。所以它的大致做法是拿 DDR 理论峰值当 100% 刻度(这一步是我按刻度反推的,文档没写内部实现)。但这只代表编译器估算出的 BPU 侧访存需求,不含 CPU/ISP/GPU 并发占用,也不含 DDR 实际效率损耗(刷新、bank 冲突、QoS),所以曲线贴近峰值只能说明估算需求高,不能直接推成板上带宽瓶颈。
CPU 与 BPU 的带宽划分:S100 是统一内存共享,公开文档没有给出按 IP 的静态带宽配额,也没有“NPU 占多少、CPU 占多少”的分区表。要量化并发影响只能实测对照:固定同一 hbm 和输入跑 hrt_model_exec perf --thread_num=1 记基线,再叠加 CPU 侧压力(如 stressapptest)重跑,看 processor_latency: BPU_inference_time_cost 的变化,压测方法参考 CPU-BPU-DDR 压力测试。
想继续往下看的话,把 model.json 里 Layer Details 对应的字段贴一小段(或说明你是想按层排热点,还是想量化 CPU 并发对 BPU 的影响),我按那个方向给具体读法。
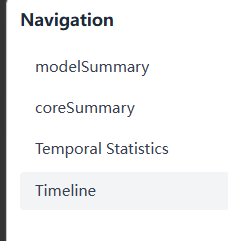
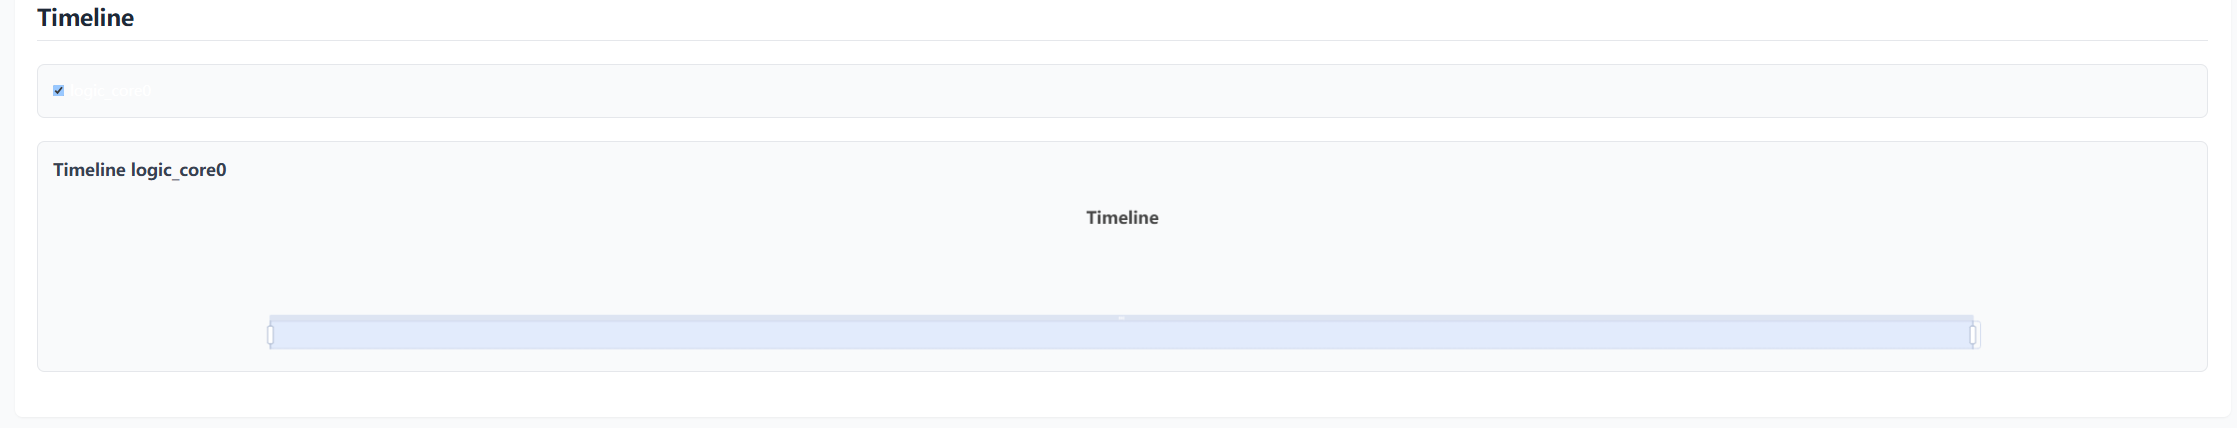
先纠正我上一轮的说法:文档写的是四个选项卡 Summary / Temporal Statistics / Layer Details / Timeline(见 性能评测及调优),但你这张导航截图是 modelSummary / coreSummary / Temporal Statistics / Timeline,确实没有逐层页。这不是你点错了位置,而是这份报告的生成路径或工具链版本和文档描述不一致,要以你实际生成的产物为准。
正确的采集方式和排查顺序:
from hbdk4.compiler import hbm_perf
hbm_perf("your_model.hbm", output_dir="./perf_S100")
cd perf_S100 && python3 -m http.server 8000
# 浏览器开 http://localhost:8000/model.html
Timeline 空白可以这样判断:Temporal Statistics 能出图,说明 model.json 已被正常加载,所以问题不是打不开,而是这份报告里的指令级数据为空。确认一下 json 里到底有没有对应字段:
python3 -c "import json;d=json.load(open('model.json'));print(list(d))"
如果 json 里也没有 Timeline 段,那就是这个 hbm 的报告没带指令级信息,需要按编译参数和版本核对。
补三个信息我就能给确定的读法:pip show hbdk4 的版本、这份 model.html 是 hb_compile(yaml 的 working_dir)产出的还是 hbm_perf 产出的、上面那条命令打印出的 model.json 顶层 key。
看起来是需要在编译的时候设置好这个debug 的选项呗 ?
方向对了一半:报告里显示哪些指标确实与编译配置/工具链版本相关——文档讲 Timeline 指标时的原话是「实际显示指标与配置相关」(模型性能分析)。但公开资料里没有“编译时打开某个 debug 开关就能补齐 Layer Details”的说明。hbdk4.compiler.compile 的签名里确实有 debug 参数(默认 False,见 HBDK Tool API Reference),文档没有定义它与报告选项卡的关系,所以先不要为了这个去重编模型,否则换了一堆条件还不知道差在哪。
先用你手上这个 hbm 重生成一份、直接看数据在不在:
from hbdk4.compiler import hbm_perf
hbm_perf("your_model.hbm", output_dir="./perf_S100")
cd perf_S100 && python3 -c "import json;d=json.load(open('model.json'));print(list(d))"
hb_compile 传统模式与 --fast-perf 的产物不同)和 hbdk4 版本。还差三项才能给确定的读法/结论:pip show hbdk4 的版本、这份报告是从 hb_compile 的 working_dir 拿的还是 hbm_perf 生成的、上面打印出的 model.json 顶层 key。
对,如果用 hbdk4.compiler.compile ,编译时加 debug=True ,再拿新生成的 HBM 跑 hbm_perf ,打开报告看 Layer Details YAML 里的 debug_mode 是精度调试项,和这里的 debug=True 是两个开关