1.YOLO简介:
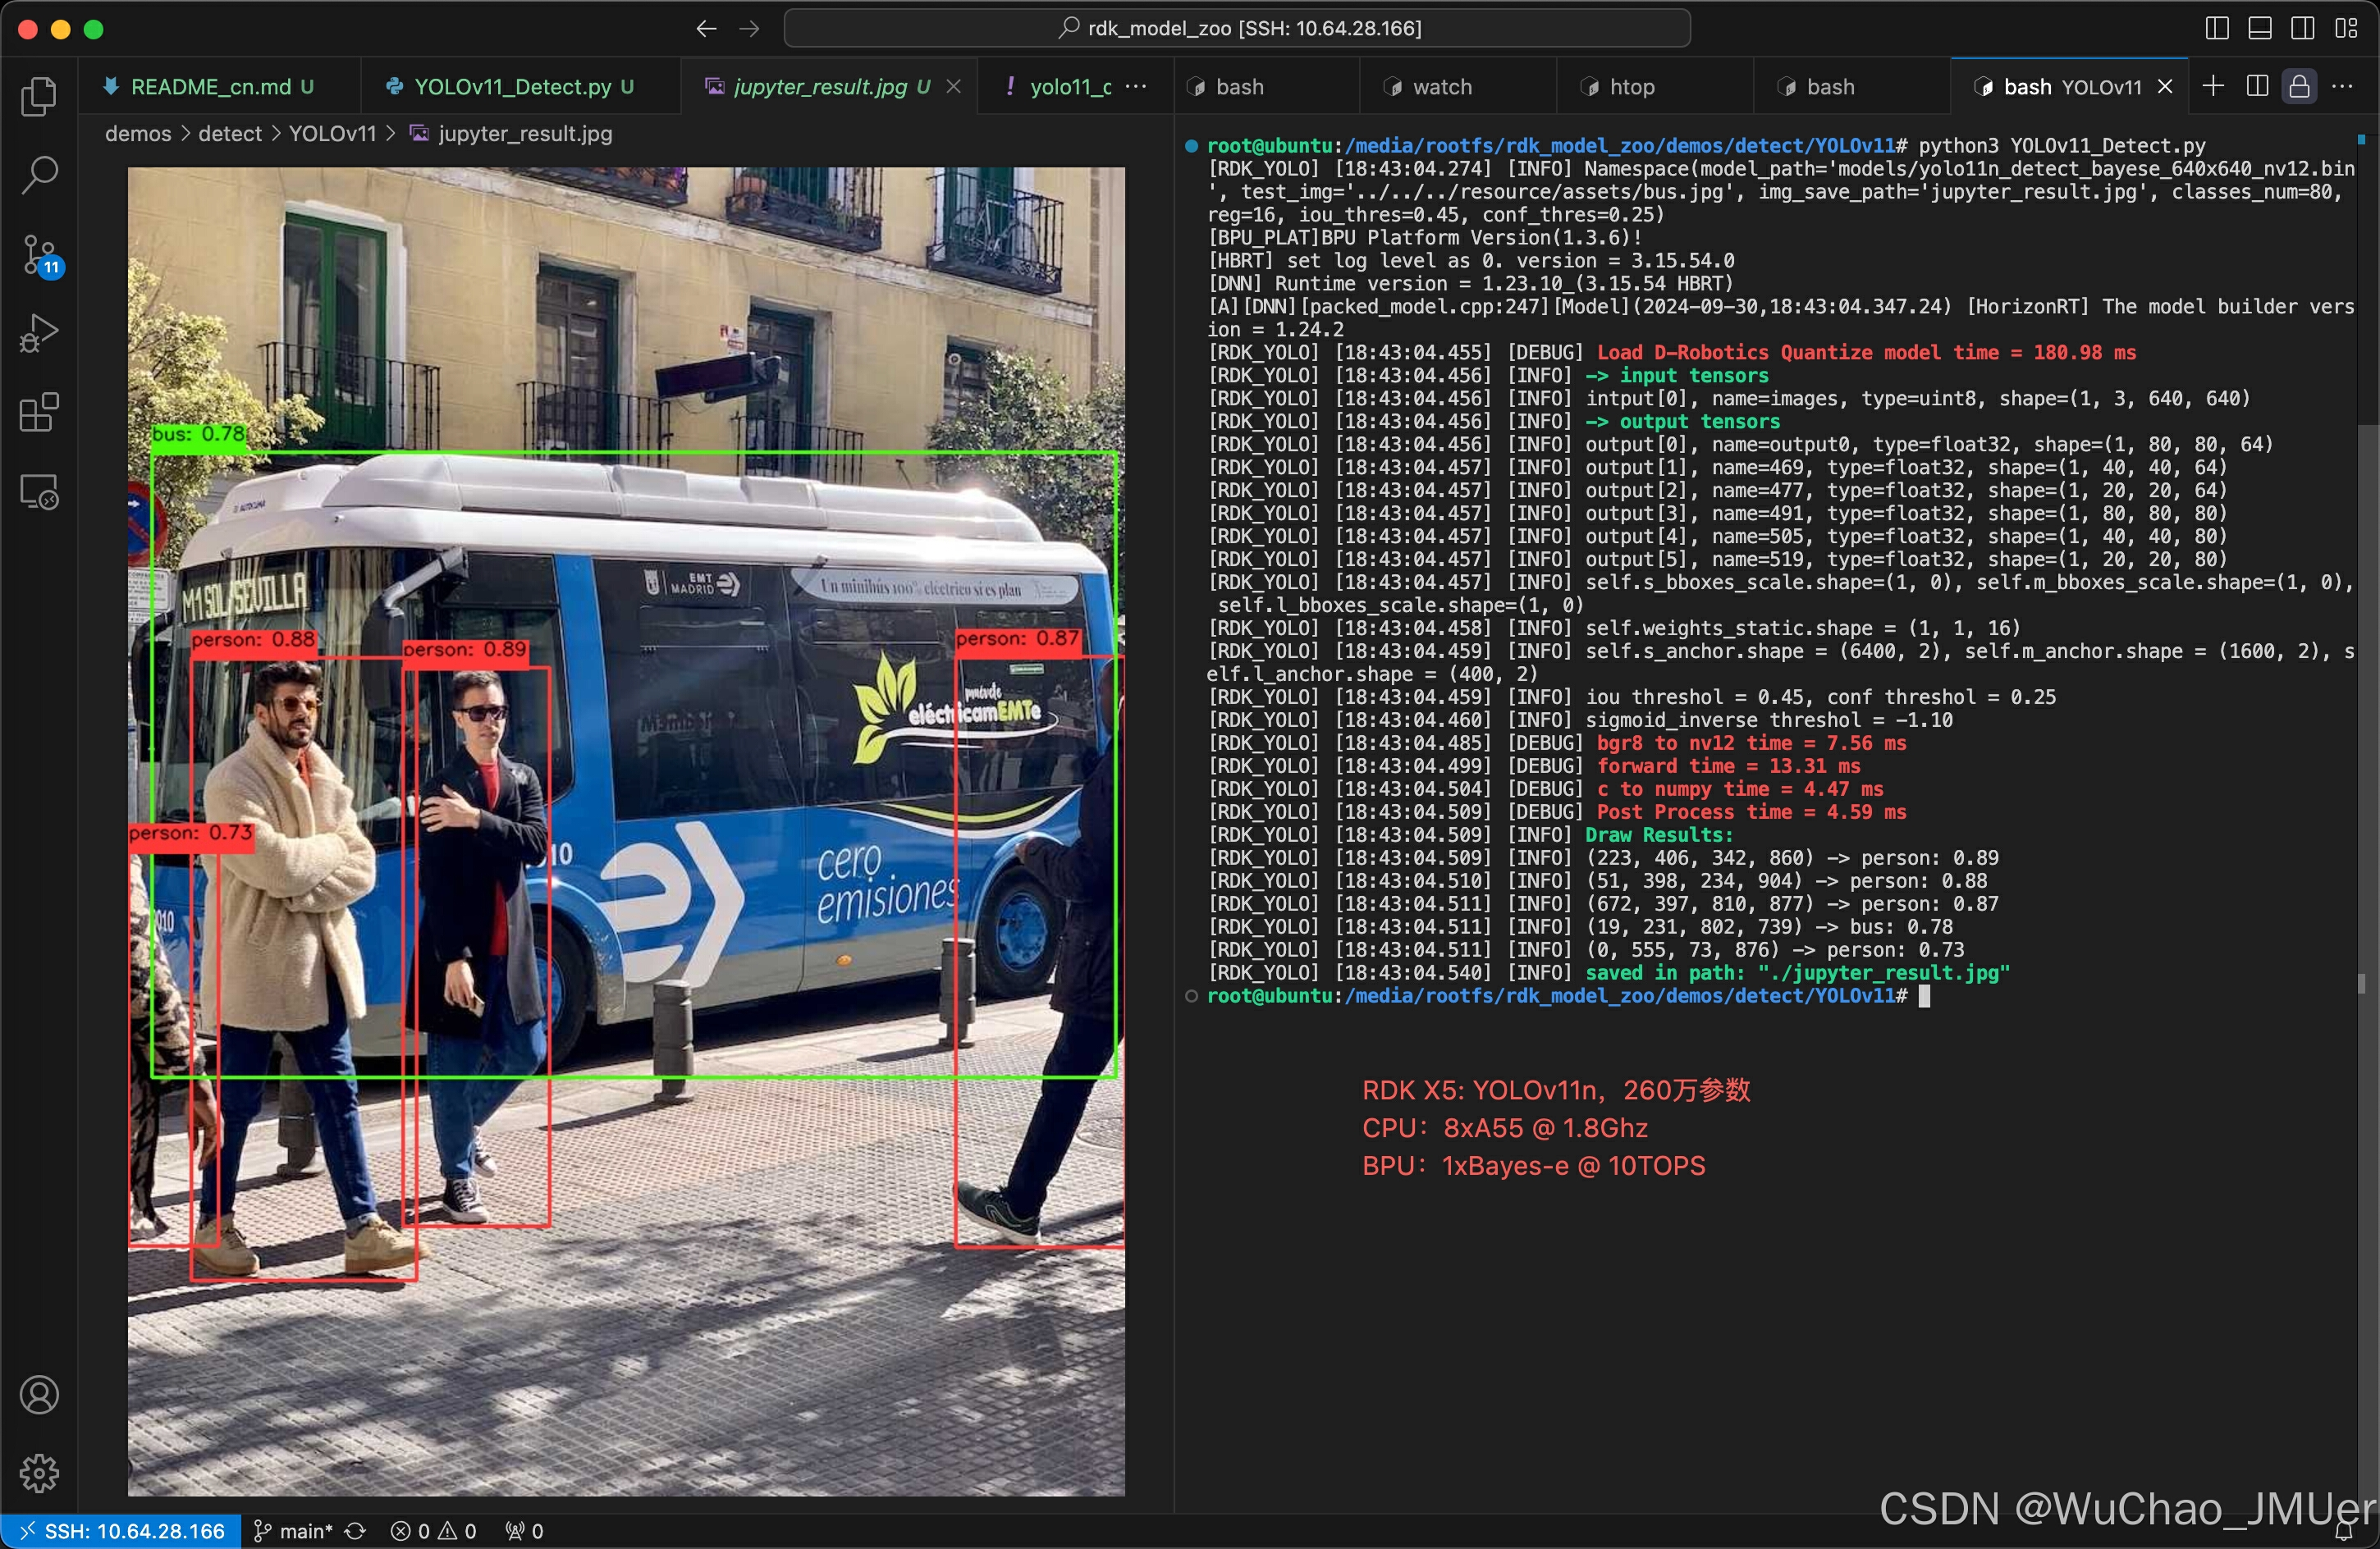
YOLO(You Only Look Once)算法是一种目标检测算法,具有速度快、精度较高等特点,在计算机视觉领域应用广泛。
YOLO(You Only Look Once)是一种流行的物体检测和图像分割模型,由华盛顿大学的约瑟夫-雷德蒙(Joseph Redmon)和阿里-法哈迪(Ali Farhadi)开发。YOLO 于 2015 年推出,因其高速度和高精确度而迅速受到欢迎。
- 2016 年发布的YOLOv2 通过纳入批量归一化、锚框和维度集群改进了原始模型。 2018 年推出的YOLOv3 使用更高效的骨干网络、多锚和空间金字塔池进一步增强了模型的性能。
- YOLOv4于 2020 年发布,引入了 Mosaic 数据增强、新的无锚检测头和新的损失函数等创新技术。
- YOLOv5进一步提高了模型的性能,并增加了超参数优化、集成实验跟踪和自动导出为常用导出格式等新功能。
- YOLOv6于 2022 年由美团开源,目前已用于该公司的许多自主配送机器人。
- YOLOv7增加了额外的任务,如 COCO 关键点数据集的姿势估计。
- YOLOv8是YOLO 的最新版本,由Ultralytics 提供。YOLOv8 YOLOv8 支持全方位的视觉 AI 任务,包括检测、分割、姿态估计、跟踪和分类。这种多功能性使用户能够在各种应用和领域中利用YOLOv8 的功能。
- YOLOv9 引入了可编程梯度信息(PGI) 和广义高效层聚合网络(GELAN)等创新方法。
- YOLOv10是由清华大学的研究人员使用该软件包创建的。 UltralyticsPython 软件包创建的。该版本通过引入端到端头(End-to-End head),消除了非最大抑制(NMS)要求,实现了实时目标检测的进步。
- YOLO11 NEW ?:Ultralytics的最新YOLO模型在多个任务上实现了最先进的(SOTA)性能。
2.开发环境:
2.1RDKX5(已经烧录好系统的!要烧录最新版本,以免后面出现问题,一些基础的配置参考1.快速开始 | RDK DOC)
2.2装配了ubuntu系统的开发机(虚拟机也可以)
(如果你还没有安装过虚拟机,这里挂一篇文章指引安装虚拟机(VMware)保姆级教程(附安装包)_vmware虚拟机-CSDN博客)
2.2.1下载oe包和docker(在linux开发机中执行这一步):
OE开发包(提供大量示例):
wget -c ftp://x5ftp@vrftp.horizon.ai/OpenExplorer/v1.2.8_release/horizon_x5_open_explorer_v1.2.8-py310_20240926.tar.gz --ftp-password=x5ftp@123$%
- Ubuntu20.04 CPU Docker镜像(仅提供运行环境,请配合OE开发包使用)(!如果是虚拟机推荐用这个):
wget -c ftp://x5ftp@vrftp.horizon.ai/OpenExplorer/v1.2.8_release/docker_openexplorer_ubuntu_20_x5_cpu_v1.2.8.tar.gz --ftp-password=x5ftp@123$%
- Ubuntu20.04 GPU Docker镜像(仅提供运行环境,请配合OE开发包使用):
wget -c ftp://x5ftp@vrftp.horizon.ai/OpenExplorer/v1.2.8_release/docker_openexplorer_ubuntu_20_x5_gpu_v1.2.8.tar.gz --ftp-password=x5ftp@123$%2.3一个适配了yolov11的环境。(可以Windows系统,这个主要用来自训练模型)(这个部分不再细讲,具体参考,这里挂载一篇文章超详细目标检测:YOLOv11(ultralytics)训练自己的数据集,新手小白也能学会训练模型,手把手教学一看就会-CSDN博客)得到的pt文件才是最重要的。
3.模型量化:
3.1将原来的pt文件导出为onnx模型:
!注意这里需要修改输出头但在那之前,要先删掉环境里的ultralytics的库(这一步是为了不用默认的export,最好两个都试一下)
pip uninstall ultralytics
conda uninstall ultralytics
然后修改输出头:
将三个特征层的Bounding Box信息和Classify信息分开输出,一共6个输出头。
在ultralytics/ultralytics/nn/modules/head.py里面,大约六十行左右,修改forward方法(这里建议把原来的注释掉就行,因为如果后续还有需要自训练模型的地方,再用这个forward就会报错)
def forward(self, x):
  bboxes = [self.cv2[i](x[i]).permute(0, 2, 3, 1).contiguous() for i inrange(self.nl)]
   clses = [self.cv3[i](x[i]).permute(0, 2, 3, 1).contiguous() for i inrange(self.nl)]
  return (bboxes, clses)
下一步,开始把自己训练得到的pt文件转换成onnx模型,先创建一个python文件,输入:
from ultralytics import YOLO
 YOLO('你的自己的pt文件的路径.pt).export(imgsz=640, format='onnx', simplify=True, opset=11)
然后运行,噔噔蹬蹬,你就得到了一个onnx文件,接着你可以开动你的小脑筋,把校准数据集和onnx模型转运到linux开发机,然后我们就可以进入你的linux系统的开发机进行模型的量化了
首先解压oe包
tar -xvfhorizon_x5_open_explorer_v1.2.8-py310_20240926.tar.gz
然后挂载镜像
sudo docker run -it --rm --shm-size=15g \   -v 自己的目录/horizon_x5_open_explorer_v1.2.8-py310_20240926:/open_explore>   -v 自己创建的,有onnx模型和校准数据集的路径:/data \   openexplorer/ai_toolchain_ubuntu_20_x5_cpu:v1.2.8-py310
参考图片
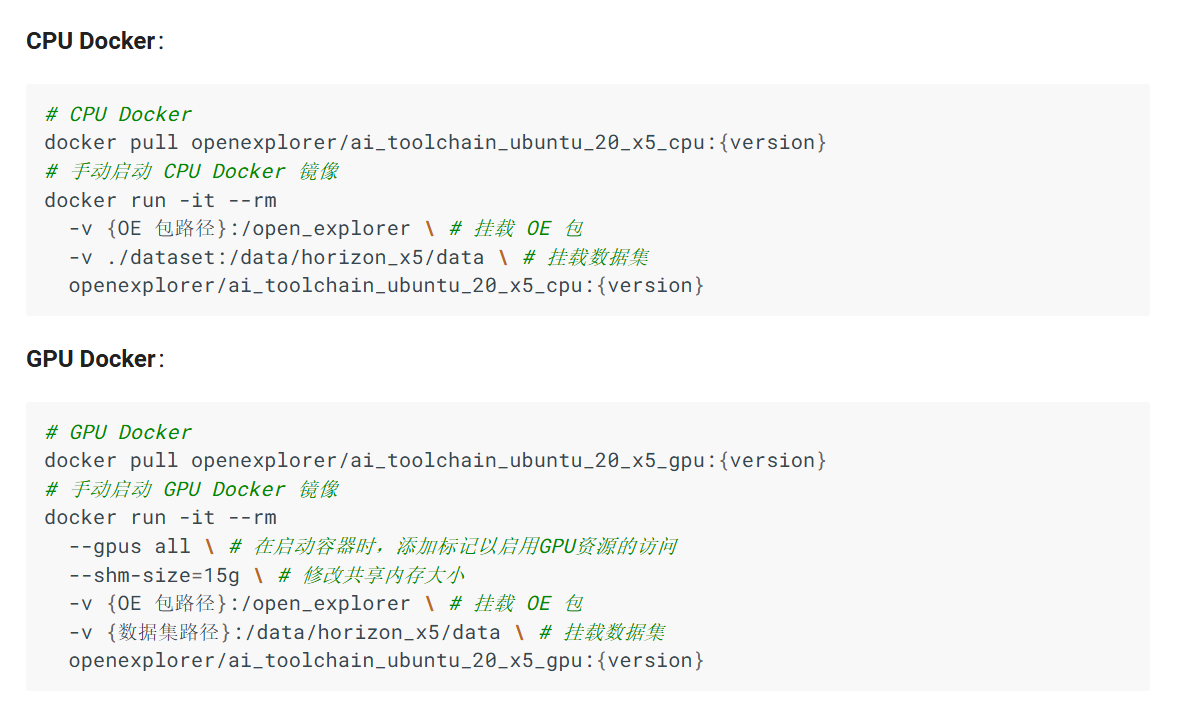
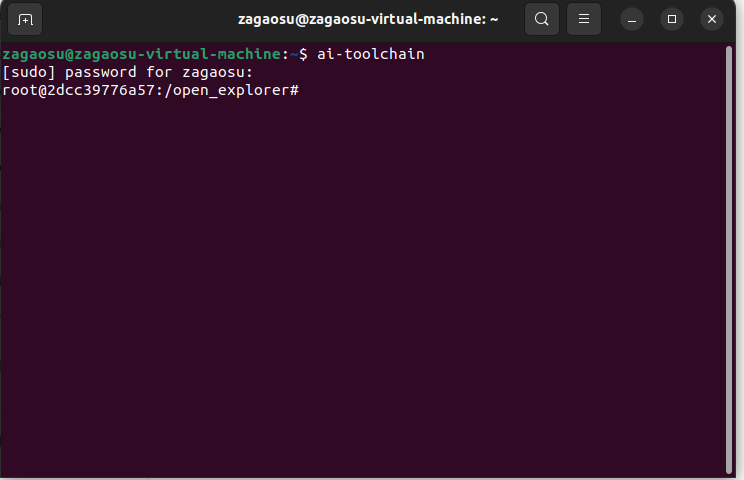
出现如图的前缀后就说明挂载成功了,如果不成功的话检查一下命令。
小tips,避免后面每次挂载都输入一长串命令,可以添加快捷命令
alias ai-toolchain="sudo docker run -it --rm --shm-size=15g \ -v /home/zagaosu/horizon_x5_open_explorer_v1.2.8-py310_20240926:/open_explore> -v /home/zagaosu/data:/data \ openexplorer/ai_toolchain_ubuntu_20_x5_cpu:v1.2.8-py310"这上面引号里的内容是自己的命令,这样后面每次输入ai-toolchain就会自动挂载了。
在转换之前,先用算法工具链检查一下onnx模型
hb_mapper checker --model-type onnx --march bayes-e --model 挂载后的onnx模型的路径.onnx输入这串代码后,后开始检查你的onnx模型,一般来说不会报错。(参考如下的图片)
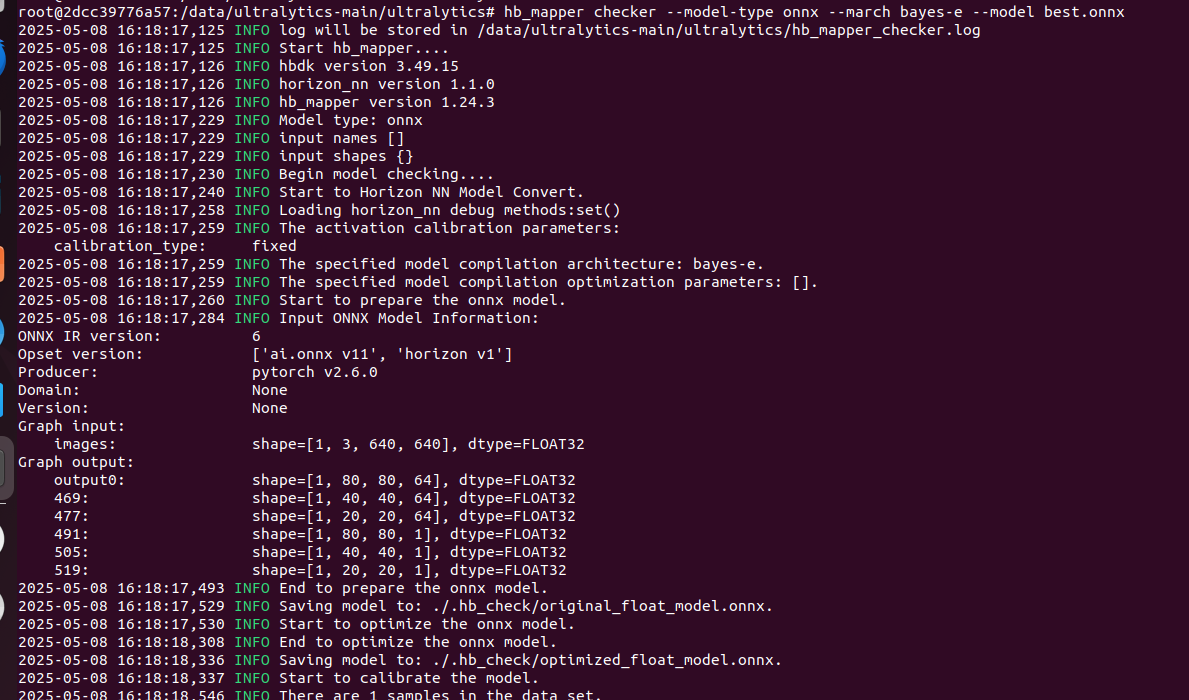
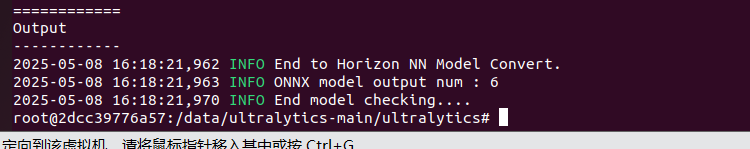
可以看到有六个输出头,然后就可以开始量化了,但是在那之前我们要先创建一个用于量化的yaml文件
model_parameters:
 onnx_model: '挂载后你的onnx的路径'
 march: "bayes-e"
 layer_out_dump: False
 working_dir: '你的工作空间'
 output_model_file_prefix: '你的模型的输出的名字'
# YOLO11 n, s, m
node_info: {"/model.10/m/m.0/attn/Softmax": {'ON': 'BPU','InputType': 'int16','OutputType': 'int16'}}
# YOLO11 l, x
# node_info: {"/model.10/m/m.0/attn/Softmax": {'ON': 'BPU','InputType': 'int16','OutputType': 'int16'},
#             "/model.10/m/m.1/attn/Softmax": {'ON': 'BPU','InputType': 'int16','OutputType': 'int16'}}
input_parameters:
#如下参数可以根据自己的需求进行修改
 input_name: ""
 input_type_rt: 'nv12'
 input_type_train: 'rgb'
 input_layout_train: 'NCHW'
 norm_type: 'data_scale'
 scale_value: 0.003921568627451
calibration_parameters:
 cal_data_dir: '你的校准数据集的路径'
 cal_data_type: 'float32'
compiler_parameters:
 compile_mode: 'latency'
 debug: False
 optimize_level: 'O3'
确认无误后就可以开始量化了(量化过程可能比较久,耐心等待)
hb_mapper makertbin --model-type onnx --config 挂载后你的yaml文件的路径然后你就可以看到一个新生成的文件夹,下面有你需要的bin文件,我们可以使用算法工具链来检验一下这个bin文件
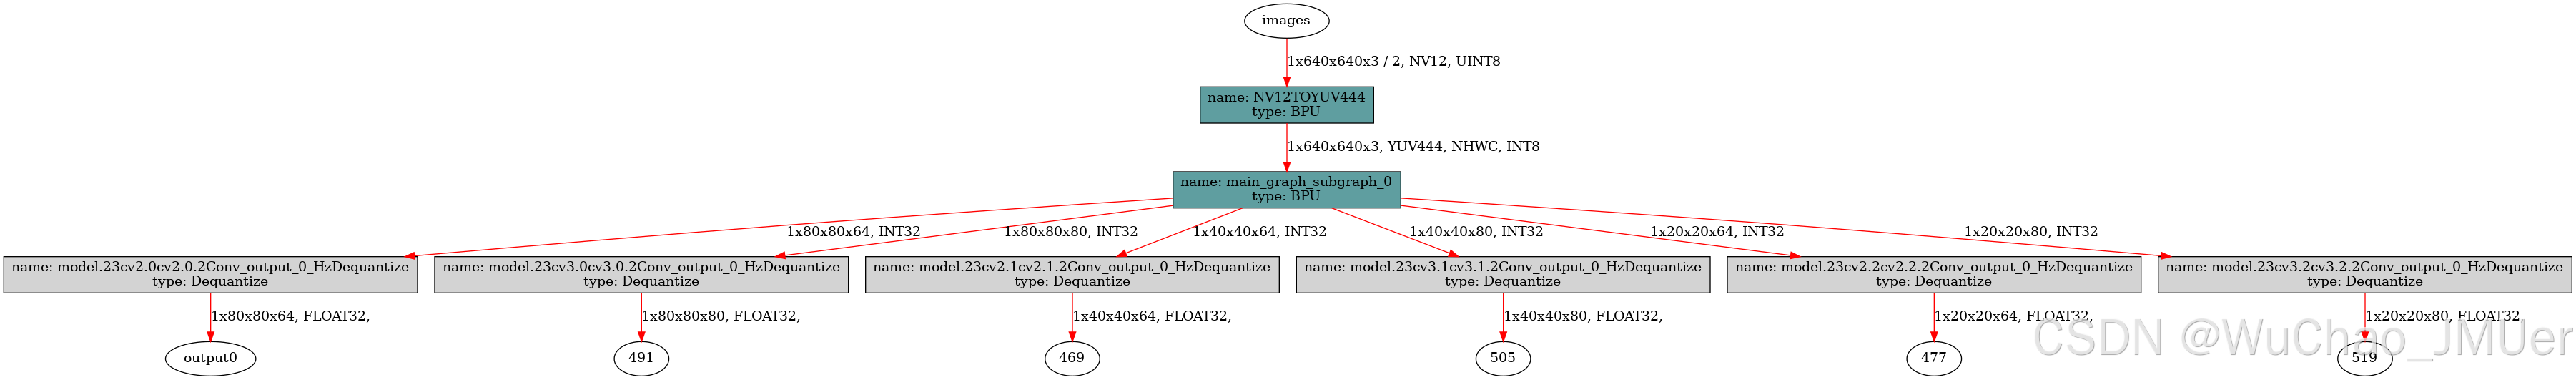
hb_perf 你自定义的文件名.bin然后你就可以得到一个hb_perf_result的文件夹,里面有检验的结果,我们主要关注里面的模型的结构图,下图为参考(为六个输出头,如果不是,可能就是你忘记删ultralytics的库了,可以删掉再试一遍)
4.板端部署
将量化得到的模型先办法copy到板端。部署的代码参考的是超哥的代码YOLOv11,地瓜RDK X5开发板,TROS端到端140FPS!
但是有些部分要修改
parser.add_argument('--classes-num', type=int, default=你的模型检测的数量, help='Classes Num to Detect.')接着找到postProcess函数进行修改
s_clses = outputs[3].reshape(-1, 自己的数量)
m_clses = outputs[4].reshape(-1, 自己的数量)
l_clses = outputs[5].reshape(-1, 自己的数量)
然后就可以跑代码了!
参考的文章
YOLOv11,地瓜RDK X5开发板,TROS端到端140FPS!
感谢各位大佬的教学