当前使用S100P,BPU可以同时跑两个大模型吗?比例同时运行2个yolo2或者一个yolo2,一个resnet18模型
结论
S100P 的 BPU 不支持同时运行两个独立的大模型实例(如 2 个 YOLOv2 或 YOLOv2+ResNet18 并发推理)。
原因分析
1. BPU 资源架构限制
- S100P 的 BPU 是独占式物理资源,不支持虚拟化或硬件级多实例调度
- 社区确认:
CONFIG_VFIO is not set,无法通过 VFIO 实现 BPU 透传或虚拟化 - 参考帖子:RDK S100 支持 BPU 虚拟化吗?
2. 内存带宽瓶颈
- BPU 推理需要独占 DDR 带宽,多模型并发会导致:
- IOMMU MAP 失败(参考 Qwen2.5 报错案例)
- 内存争抢,推理延迟激增
- S100P 虽有 12GB 内存,但 BPU 可访问的 contiguous memory 有限
3. 调度机制限制
- 参考 X3 的 多核 BPU 调度文档:
- 单核模型:可手动指定
core_id,但 S100P 的 BPU 核心数量与 X3 不同(需确认具体核心数) - 双核模型:编译时设置
core_num: 2,但这是单模型占用双核,不是多模型并发 - 异步接口由驱动自动调度,无法保证多模型隔离
- 单核模型:可手动指定
可行方案
方案 1:时间分片(推荐)
# 伪代码示例:交替推理
while true:
    run_model_yolo()    # YOLOv2 推理
    run_model_resnet()  # ResNet18 推理
    # 通过线程/进程控制调度
- 优点:实现简单,资源冲突小
- 缺点:总帧率 = 单模型帧率 / 2
方案 2:模型融合(高级)
- 将 YOLOv2 和 ResNet18 合并为单一多任务模型
- 使用多输出头,一次 BPU 推理完成两个任务
- 需重新训练/转换模型
方案 3:CPU+BPU 混合部署
- 将较轻的模型(如 ResNet18)放到 CPU 运行
- BPU 专用于 YOLOv2
- 使用
hrut_somstatus监控 BPU 利用率
排查建议
如需确认具体限制,建议执行:
# 1. 查看 BPU 状态
hrut_somstatus

# 2. 测试单模型最大负载
# 参考:https://forum.d-robotics.cc/t/topic/34996

# 3. 尝试加载两个 HBM 模型(预期会失败)
hrt_model_exec model1.hbm &
hrt_model_exec model2.hbm &
社区资源
建议:将你的测试数据和需求发到社区,看是否有其他开发者在 S100P 上实现过类似的多模型调度方案。
你好,VideoMAEv2 (https://huggingface.co/OpenGVLab/VideoMAEv2-Base/tree/main)这个开源模型可以帮忙适配吗? 我这边目前压测效果不好,bpu占比基本上不去,多数时间保持0。
关于 VideoMAEv2 适配与 BPU 利用率为 0 的问题
结论
VideoMAEv2 目前官方 Model Zoo 未提供 S100P 的预编译 HBM 模型,需要自行转换。BPU 利用率为 0 说明模型实际在 CPU 上运行,未成功调用 BPU 加速。
BPU 利用率为 0 的核心原因
| 可能原因 | 概率 | 排查方法 |
|---|---|---|
| 模型未正确转换为 HBM 格式 | 高 | 检查是否有 .hbm 文件 |
| 算子不支持 BPU,回退 CPU | 高 | 查看 hb_compile 日志中的算子分布 |
| 量化参数错误(如 FP16) | 高 | S100P BPU 仅支持 INT8 |
| 推理调用方式错误 | 中 | 检查是否使用 hrt_model_exec 或正确 API |
| 输入数据格式不匹配 | 中 | 检查 NV12/NHWC 格式 |
排查步骤
 确认模型转换状态
# 检查是否有 HBM 文件
ls -lh *.hbm

# 查看编译日志中的算子分布
hb_compile --config your_config.yaml 2>&1 | grep -E "BPU|CPU"
关键点:如果日志显示大部分算子在 CPU 上运行,说明模型未成功映射到 BPU。
 检查量化配置
# 正确的 S100P 量化配置示例
quantization:
  data_type: "int8"  # ⚠️ 不能用 float16
  calibration_method: "minmax"
 注意:从社区案例看,S100P 设置
float16 会导致所有算子回退到 CPU(参考 S100/S100P ONNX 算子 BPU 约束)。
 验证推理调用
# 正确的板端推理命令
hrt_model_exec --model your_model.hbm --input input.nv12

# 同时监控 BPU 状态(新开一个终端)
hrut_somstatus  # 观察 ratio 是否变化
 检查 VideoMAEv2 特殊算子
VideoMAEv2 包含大量 Transformer/Attention 算子,需确认:
MultiHeadAttention是否支持 BPULayerNorm、GELU等激活函数是否有 BPU 实现- 时序建模部分(3D 卷积/Temporal Attention)是否兼容
参考社区讨论:关于征程 S100 BPU 对 Transformer 算子支持的需求
VideoMAEv2 适配建议
方案 A:使用官方 LLM 工具链(推荐)
VideoMAEv2 属于视频理解模型,可参考 VLM 部署方案:
- 参考 SmolVLM 部署案例
- 将 VideoMAEv2 的视觉编码器部分单独转换为 HBM
- 时序处理部分可能需要 CPU 辅助
方案 B:算子级优化
# 伪代码:分离 BPU/CPU 计算
def inference(video_frame):
    # BPU 部分:空间特征提取
    features = bpu_model.run(frame)  # ViT backbone

    # CPU 部分:时序建模(如不支持 BPU)
    temporal_features = cpu_temporal_model(features)

    return classification_result
方案 C:简化模型
- 使用 VideoMAEv2 的 Base/Small 版本而非 Large
- 降低输入分辨率(如 224x224 而非 448x448)
- 移除不必要的后处理算子
快速验证脚本
#!/bin/bash
# 检查 BPU 是否真正被调用

echo "=== 1. 检查 HBM 文件 ==="
ls -lh *.hbm

echo "=== 2. 查看模型元信息 ==="
hrt_model_info --model your_model.hbm

echo "=== 3. 启动推理(后台) ==="
hrt_model_exec --model your_model.hbm --loop 100 &
PID=$!

echo "=== 4. 监控 BPU 状态(5 秒) ==="
for i in {1..5}; do
    hrut_somstatus | grep -E "BPU|ratio"
    sleep 1
done

kill $PID
下一步行动
- 提供你的转换日志:将
hb_compile的完整输出发到帖子中,我可以帮你分析哪些算子未映射到 BPU - 确认模型来源:你是直接从 HuggingFace 转换,还是已有 ONNX 中间格式?
- 测试官方模型:先跑通 Model Zoo 中的 YOLO 模型,确认 BPU 调用链路正常
建议:VideoMAEv2 的 Transformer 架构在 S100P 上可能遇到算子支持问题,可以考虑先用 InternVL 或 SmolVLM 等已有适配案例的模型验证流程,再迁移到 VideoMAEv2。
需要我帮你查找 VideoMAEv2 的具体转换配置示例吗?
使用这个模型的需求背景是?有特定模型的适配需求和具体的项目规划可以联系
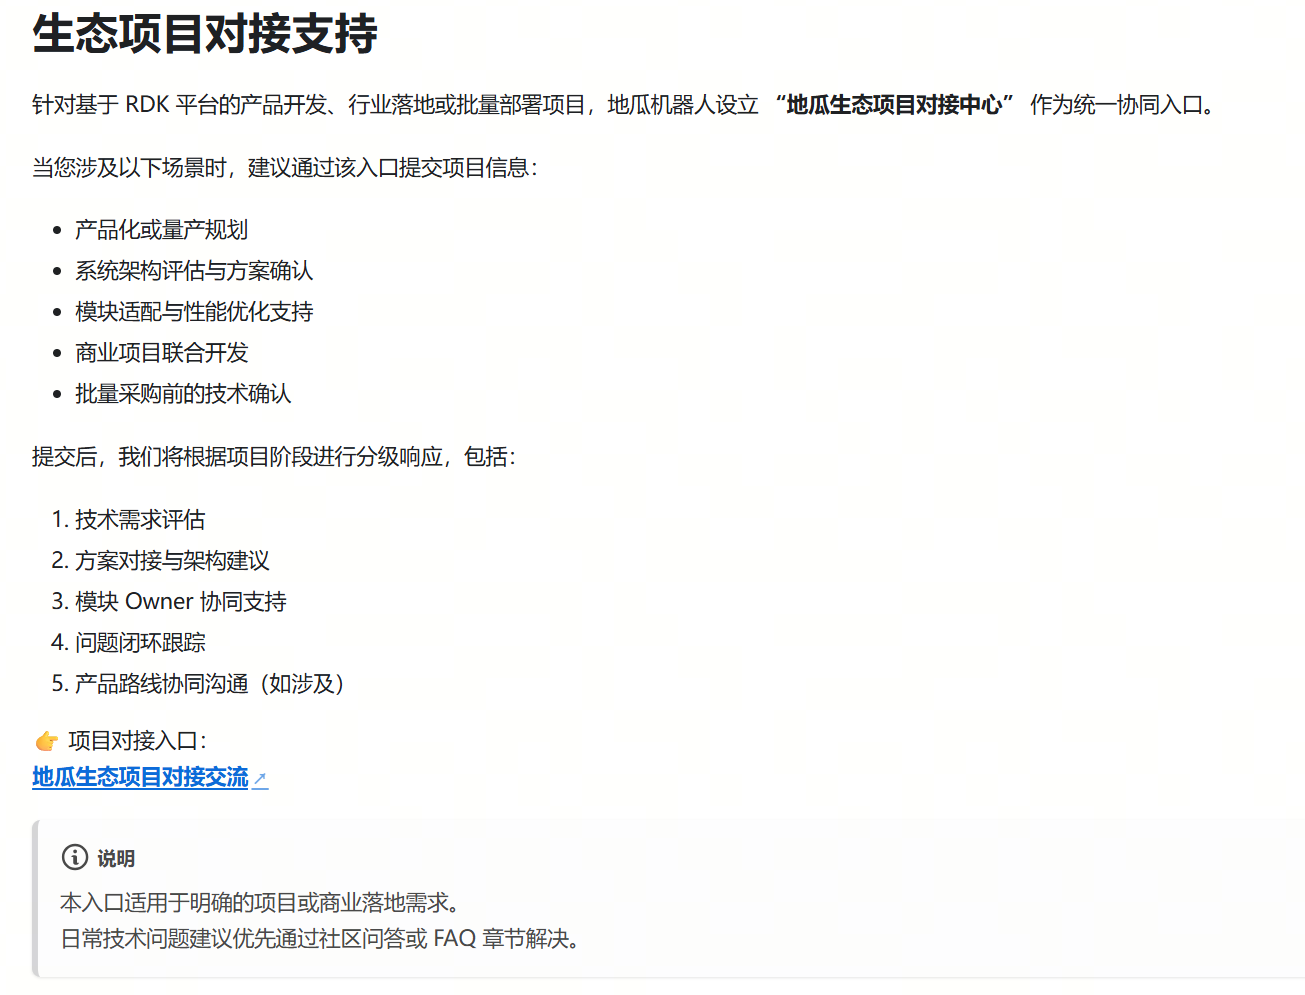
https://horizonrobotics.feishu.cn/share/base/form/shrcnpxBa3PjdjFmtxZS3tBXw0e
来进行模型落地工作,一般模型可以附上编译日志来协助调试,或者在model zoo提issue由生态侧来排期适配
如果按照BPU调度的方式,可以最大调度几个模型,如何调度
结论
S100P 的 BPU 同一时间只能调度 1 个模型实例进行推理,无法真正实现多模型并发。
核心限制
1. 硬件架构
- S100P 的 BPU 是单一物理加速器,不支持硬件级虚拟化或多实例隔离
- 社区确认:
CONFIG_VFIO is not set,无法通过 VFIO 实现 BPU 透传(参考 BPU 虚拟化讨论) - 与 X3 的双核 BPU 不同,S100P 的 BPU 设计为独占式资源
2. 调度机制
- BPU 驱动采用排队调度:当多个进程/线程同时请求 BPU 时,驱动会串行化处理
- 即使你启动多个
hrt_model_exec进程,实际也是交替执行,而非并行 - 参考 压力测试案例:多进程测试时 BPU 利用率仍为单实例水平
3. 内存带宽瓶颈
- BPU 推理需要独占 DDR 带宽,多模型并发会导致:
- IOMMU MAP 失败(参考 Qwen2.5 报错)
- 内存争抢,推理延迟激增
调度策略与最佳实践
虽然无法真正并发,但可以通过以下方式优化多模型切换效率:
方案 1:时间分片调度(推荐)
# 伪代码:手动时间分片
import threading
import time

class BPUScheduler:
    def __init__(self):
        self.current_model = None
        self.lock = threading.Lock()

    def run_model(self, model_name, input_data):
        with self.lock:
            # 加载模型(如果未加载)
            if self.current_model != model_name:
                self.load_model(model_name)
                self.current_model = model_name

            # 执行推理
            result = self.infer(input_data)
            return result

# 使用示例
scheduler = BPUScheduler()
result1 = scheduler.run_model("yolo", frame1)
result2 = scheduler.run_model("resnet", frame2)
效果:
- 总帧率 ≈ 单模型帧率 / 模型数量
- 延迟可控,无资源冲突
方案 2:模型融合(高级)
将多个模型合并为单一多任务模型:
- 共享 Backbone(如 ResNet)
- 多输出头(检测 + 分类)
- 一次 BPU 推理完成所有任务
优点:真正的"并发",BPU 利用率最高
缺点:需重新训练/转换模型
方案 3:CPU+BPU 混合部署
# BPU 运行 YOLOv2(重模型)
hrt_model_exec --model yolo.hbm &

# CPU 运行 ResNet18(轻模型)
python3 resnet_cpu_infer.py &
适用场景:一个模型较重(YOLO),一个较轻(分类)
监控与验证
# 1. 查看 BPU 状态
hrut_somstatus

# 2. 测试多进程调度(预期串行)
hrt_model_exec --model model1.hbm --loop 1000 &
hrt_model_exec --model model2.hbm --loop 1000 &

# 3. 观察 BPU 利用率
watch -n 1 "hrut_somstatus | grep ratio"
预期结果:ratio 不会超过单实例的最大值,说明是串行调度。
总结对比
| 调度方式 | 最大模型数 | 真正并发 | 实现难度 | 推荐度 |
|---|---|---|---|---|
| 时间分片 | N 个(交替) |  |
 |
|
| 模型融合 | 1 个(多任务) |  |
|
|
| CPU+BPU 混合 | 2 个(异构) | |
|
|
| 多进程并发 | N 个(排队) | |
|
建议
- 优先使用时间分片:实现简单,稳定性高
- 如需真正并发:考虑模型融合或 CPU 卸载
- 避免多进程硬抢 BPU:可能导致 IOMMU 报错或系统不稳定
下一步:如果你的应用场景对延迟敏感,建议提供具体需求(帧率、模型类型),我可以帮你设计最优调度方案。
那如果跑32个推理任务的话,比如任务1到bpu推理1ms,任务2再到bpu推理1ms这种分时复用吗。 还是任务1到bpu跑完后,再调度其他任务进bpu来跑
只有一个BPU核,多任务会串行推理